4. Remontée du système : RLTFR8#
Si le nombre de seconds membres à résoudre simultanément est supérieur à 4, on fait appel à une méthode par blocs implémentée par la routine RLBFR8, sinon MLTDRA est appelé pour chaque second membre.
Données : ce sont les pointeurs issus de MLTPRE:
\(\mathit{ADRESS}\) ,
\(\mathit{GLOBAL}\) ,
\(\mathit{SUPND}\) ,
\(\mathit{LGSN}\) ,
\(\mathit{ANC}\) ,
\(\mathit{NOUV}\) ,
\(\mathit{SEQ}\) ,
\(\mathit{LGBLOC}\) ,
\(\mathit{NCBLOC}\) ,
\(\mathit{DECAL}\) .
Et la matrice factorisée issue de MULFR8
\(\mathit{FACTOL}\) : .VALF (et \(\mathit{FACTOU}\) : .WALF en non symétrique)
Les seconds membres:
\(\mathit{XSOL}(\mathrm{1 }:\mathrm{\ne },\mathrm{1 }:\mathit{NBSOL})\)
Résultats : Ils se retrouvent dans le tableau qui a contenu les seconds membres: \(\mathit{XSOL}\) .
4.1. MLTDRA#
Cette routine effectue successivement, pour un seul second membre, la descente, la division par le terme diagonal, et la remontée. Dans la descente, on fait appel au produit matrice-vecteur \(\mathit{DGEMV}\) des bibliothèques Blas, au-delà d’un certain seuil. En dessous on optimise «à la main» dans la routine SSPMVB.
(Cette optimisation est une vectorisation écrite pour le CRAY, elle pourrait donc être revue voire supprimée! )
4.2. RLBFR8#
En présence de plusieurs seconds membres, les appels à DGEMV cités au paragraphe précédent, sont remplacés par des appels à DGEMM, produit matrice*matrice, sur des blocs matriciels d’ordre \(\mathit{NB}\) . On vise ainsi la performance fournie par ces Blas de niveau 3, comme dans la factorisation numérique.
Les routines appelées sont:
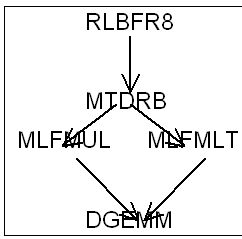
|
Figure 5 Descente-remontée par blocs