3. Factorisation numérique MULFR8#
On a affaire à la factorisation proprement dite, les routines appelées sont:
MLTPRE
MLTASA
MLTFC1
MLTPRE, vu précédemment, est appelé si nécessaire. On vérifie qu’il n’a pas déjà été appelé en amont, dans ce cas on sort de la routine.
3.1. MLTASA#
Cette routine effectue l’injection des termes initiaux de la matrice dans la matrice factorisée. Le tableau \(\mathit{ADINIT}\) calculé précédemment par MLTPRE fournit les adresses.
Données :
L’enregistrement .VALM de la structure NOMMAT de type sd_matr_asse fournie.
\(\mathit{ADINIT}\) et \(\mathit{LGBLOC}(\mathrm{1 }:\mathit{NBLOC})\) calculés par MLTPRE.
Résultats :
MLTASA crée une collection dispersée de nom \(\mathit{FACTOL}\) ayant \(\mathit{NBLOC}\) blocs de longueurs données par \(\mathit{LGBLOC}(\mathrm{1 }:\mathit{NBLOC})\) .
Dans le cas non –symétrique, la routine lit 2 «.VALM» de noms respectifs \(\mathit{MATI}\) et \(\mathit{MATS}\) , parties inférieure et supérieure de la matrice initiale, et crée 2 collections \(\mathit{FACTOL}(\mathit{ower})\) et \(\mathit{FACTOU}(\mathit{pper})\) .
3.2. MLTFC1#
On est dans le cas où la pile des matrices frontales est rangée dans un tableau FORTRAN nommé \(\mathit{PILE}\) et alloué par WKVECT dans l’appelant MULFR8, ce tableau est détruit en fin de routine.
Une version avec les matrices frontales en collection dispersée a été écrite (MLTFCB) , mais n’est pas utilisée.
MLTFC1 a la structure suivante:
Dans une boucle externe sur les blocs de la factorisée,
Chargement du bloc en mémoire
Boucle sur les nœuds du bloc
\(\mathit{SEQ}\) fournit l’ordre d’élimination
On élimine donc le super-nœud \(\mathit{SNI}\) en différentes phases:
Assemblages des matrices «filles» par appel à MLTAFF et MLTAFF
Élimination des colonnes de \(\mathit{SNI}\) qui sont les colonnes de la factorisée: MLTFLM
Mise à jour des inconnues restantes dans la matrice frontale (complément de Schur): MLTFMJ
Fin de boucle
Fin de boucle
Pour IB = 1,NBLOC ! Boucle sur les blocs de la factorisée
JEVEUO(JEXNUM(FACTOL,IB),”L”,IFACL)
! Le bloc IB de la collection FACTOL est chargé en IFACL
Pour NC = 1, NCBLOC(IB) ! Boucle sur les Super-nœuds du bloc IB
ISN = ISN +1
SNI= SEQ(ISN)
Pour tous les SN fils de SNI! assemblage des matrices filles
mltafp
mltaff
! fin de l’assemblage des matrices filles
mltflm ! élimination du SN: factorisation sur les colonnes du SN
mltfmj ! apport des colonnes éliminées sur les autres degrés de liberté du front, mise à jour de la matrice frontale
! fin de boucle sur les super nœuds
! fin de boucle sur les blocs
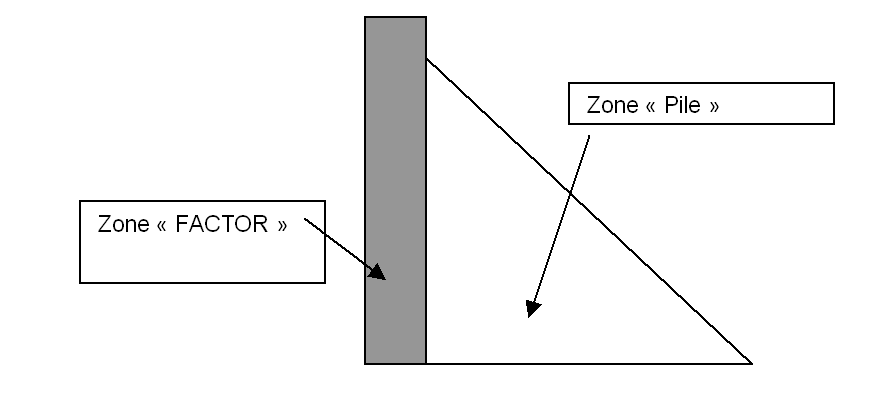
Avant de décrire les routines appelées, il faut préciser la façon dont la matrice est rangée. On regarde le schéma suivant:
|
Figure 3 Décomposition de la matrice frontale en 2 zones de stockage
La partie rectangulaire grisée représente la zone «active de la matrice frontale», ce sont les colonnes du \(\mathit{SN}\) qui vont être éliminées, et vont constituer les colonnes de la matrice factorisée \(\mathit{FACTOR}\) . Pour éviter une copie de mémoire entre la matrice frontale et \(\mathit{FACTOR}\) , on stocke directement les coefficients dans \(\mathit{FACTOR}\) , on dira que c’est la partie « \(\mathit{FACTOR}\) » de la matrice frontale. A coté, on a la zone «passive» de la matrice frontale, (complément de Schur en fait), qui sera stockée dans la pile, de même, pour éviter une copie de mémoire, on stocke directement cette partie de la matrice dans la pile.
Mltafp et mltaff sont les routines qui assemblent les matrices frontales «filles» dans la matrice frontale «mère».
3.2.1. mltafp#
Cette routine assemble les coefficients de la matrice frontale «fille», dans la zone « \(\mathit{FACTOR}\) » de la matrice frontale «mère».
3.2.2. mltaff#
Cette routine copie les coefficients de la matrice frontale «fille», dans la zone «pile» de la matrice frontale «mère».
3.2.3. mltflm#
Elimination du super nœud \(\mathit{SN}\) , i.e. factorisation partielle de la matrice frontale, travail dans la zone « \(\mathit{FACTOR}\) ».
mltflm appelle:
dgemv : routine Blas qui effectue les produits matrice*vecteur
mltfld (appel à DGEMV)
mltflj (appel à DGEMM).
3.2.4. mltfmj#
Mise à jour de la zone « \(\mathit{PILE}\) » qui est modifiée par l’élimination du \(\mathit{SN}\) .
mltfmj appelle:
dgemm: routine Blas qui effectue les produits matrice-matrice.
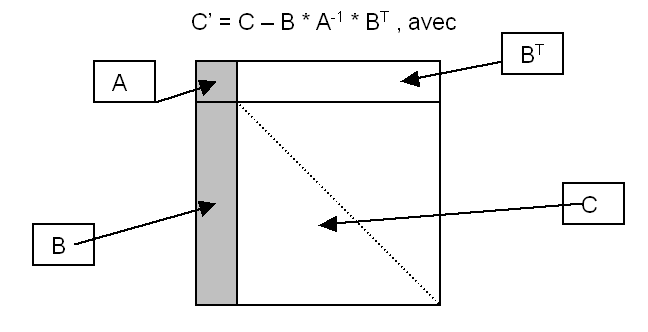
mltfmj est la routine la plus consommatrice de temps de calcul, elle effectue la mise à jour de la matrice frontale sur les lignes et les colonnes des degrés de liberté voisins de ceux éliminés, c’est une opération que l’on peut écrire:
|
Afin de diminuer les coûts de calcul, on divise virtuellement les matrices \(A\) , \(B\) et \(C\) en sous blocs d’ordre \(\mathit{NB}\) et l’opération (1) ci-dessus est effectuée par blocs en appelant la routine Blas DGEMM. Cette routine optimisée par le constructeur sur chaque machine tire profit du fait que les petits blocs d’ordre \(\mathit{NB}\) ainsi multipliés tiennent dans le cache primaire, diminuant ainsi les coûts d’accès à la mémoire. \(\mathit{NB}\) est fixé actuellement à 96, cette valeur généralement de l’ordre de quelques dizaines dépend de la taille du cache \(\mathit{L1}\) , le plus proche du processeur et de la taille des problèmes traités. Il pourrait être ré estimer de temps en temps en fonction des nouvelles acquisitions de machines, sur un ensemble de cas-test significatifs. Les essais effectués précédemment ont montré que les performances variaient peu quand NB variait autour de 96.
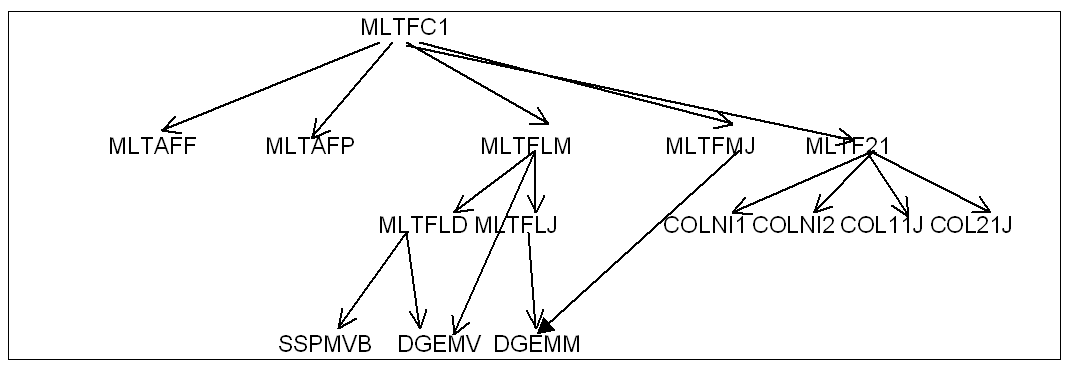
mltflm utilise aussi cette division en blocs et utilise DGEMM par l’intermédiaire de mltflj. (Dans le cas où le nombre de colonnes à éliminer est inférieur à un certain seuil (\(\mathit{pmin}=10\) ), l’appel à ces 2 dernières routines est remplacé par l’appel à MLFT21). Ceci a été fait par souci d’optimisation de l’élimination des «petits» super-nœuds, il conviendrait de vérifier que cela est toujours justifié. Ainsi, par souci de simplification, après vérification de l’absence de dégradation des performances pour les petits cas, on pourrait supprimer ce seuil et ainsi éliminer un branche d’appel de sous-programme.
Pour illustrer ceci, l’arborescence des routines appelées dans le cas symétrique est le suivant:
|
Figure 4 Factorisation (cas réel symétrique).