7. Parallélisation#
La parallélisation dans MULT_FRONT est réalisée par directives Openmp. Ces directives sont placées dans les routines suivantes:
Cas réel symétrique: MLTFMJ, MLTFLJ
Cas complexe symétrique: MLTCMJ, MLTCLJ
Cas réel non symétrique: MLNFMJ, MLNFLJ
Cas complexe non symétrique: MLNCMJ, MLNCLJ
La parallélisation implémentée est «dite» interne, elle a lieu à l’intérieur du processus d’élimination d’un super nœud. L’élimination des super nœuds, dite «externe» peut aussi être parallélisée. Mais elle n’est pas implémentée pour la raison suivante: L’élimination simultanée de plusieurs super nœuds nécessite une occupation de la mémoire supérieure à celle de la version séquentielle. Or le souci de l’occupation de la mémoire a toujours prédominé celui du gain de temps de restitution lors des développements précédents de MULT_FRONT.
La parallélisation interne, elle, ne nécessite aucune mémoire supplémentaire à celle de la version séquentielle, elle ne nécessite non plus aucun développement de code particulier, seul un simple ajout de directives.
On va décrire la parallélisation de la routine MLTFMJ, celle de MLTFLJ suit les mêmes principes, ainsi que les autres routines citées plus haut.
|
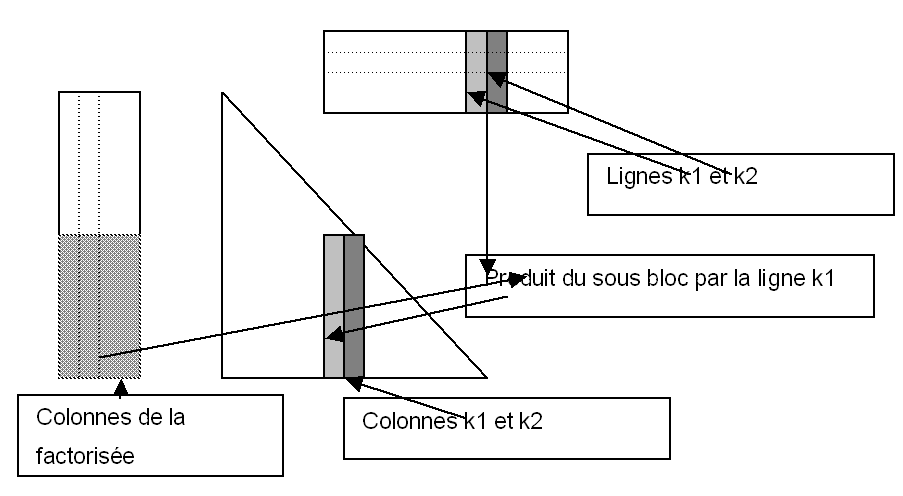
Figure 9 Schéma de la mise à jour de la matrice frontale
On voit sur la Figure ci-dessus, un schéma de la mise à jour de la matrice frontale lors de l’élimination d’un nœud. Le triangle représente la partie inférieure de la matrice frontale, et les 2 rectangles représentent les colonnes de la matrice factorisée, colonnes correspondant uniquement au super nœud éliminé. Dans un premier temps, on raisonnera par colonnes. On sait que l’on met à jour la colonne \(\mathit{k1}\) de la matrice frontale en lui soustrayant le produit du sous-bloc de colonnes (en grisé ci-dessus) par la ligne \(\mathit{k1}\) (multipliée elle-même par les termes diagonaux). (opération de type Blas2). Cette opération de mise à jour est parallélisée sans problème par une directive OpenMP, les colonnes de la matrice frontale sont adjacentes, il n’y a aucun conflit d’adresses. Toutes les variables sont partagées, sauf les indices de boucles et les variables locales. On a vu ci-dessus que par souci de performance, on travaille par bloc de colonnes, afin d’utiliser des Blas3, la parallélisation évoquée ci-dessus se fait donc en fait sur les blocs de colonnes et non sur les colonnes elles-mêmes.
Aperçu du code:
C$OMP PARALLEL DO DEFAULT(PRIVATE)
C$OMP+SHARED(N,M,P,NMB,NB,RESTM,FRONT,ADPER,DECAL,FRN,TRAV,C)
C$OMP+SHARED(TRA,TRB,ALPHA,BETA)
C$OMP+SCHEDULE(STATIC,1)
DO 1000 KB = 1,NMB
NUMPRO= MLNUMP()
C K : INDICE DE COLONNE DANS LA MATRICE FRONTALE (ABSOLU DE 1 A N)
K = NB*(KB-1) + 1 +P
DO 100 I=1,P
S = FRONT(ADPER(I))
ADD= N*(I-1) + K
DO 50 J=1,NB
TRAV(I,J,NUMPRO) = FRONT(ADD)*S ! TRAV contient les produits : terme diagonal*ligne
ADD = ADD + 1
50 CONTINUE
100 CONTINUE
DO 500 IB = KB,NMB
IA = K + NB*(IB-KB)
IT=1
CALL DGEMM( TRA,TRB,NB,NB,P,ALPHA,FRONT(IA),N,
& TRAV(IT,1,NUMPRO), P,BETA,C(1,1,NUMPRO), NB)
C RECOPIE
C
DO 501 I=1,NB
I1=I-1
IF(IB.EQ.KB) THEN
J1= I
IND = ADPER(K + I1) - DECAL
ELSE
J1=1
IND = ADPER(K + I1) - DECAL + NB*(IB-KB) - I1
ENDIF
DO 502 J=J1,NB
FRN(IND) = FRN(IND) +C(J,I,NUMPRO)! Recopie dans la matrice frontale frn
IND = IND +1
502 CONTINUE
501 CONTINUE
500 CONTINUE
1000 CONTINUE
C$OMP END PARALLEL DO
N.B. Parallélisation.
La version séquentielle nécessite un tableau de travail \(\mathit{TRA}\) , écrit pour chaque bloc, il est nécessaire de le dupliquer pour la parallélisation. Dans la boucle parallèle, on fait appel à la fonction MLNUMPqui fournit le numéro de thread traitant l’itération de boucle; NUMPRO, on travaille ensuite dans le plan NUMPROdu tableau \(\mathit{TRAV}\) .