4. Opérandes#
4.1. Opérande UNITE_ESCL#
♦ UNITE_ESCL
Numéro d’unité logique du fichier esclave, attribué dans l’interface Astk (colonne UL). L’extension de ce fichier peut être quelconque.
4.2. Opérandes RESU_EXP,RESU_CALC,FONC_EXP,NOM_FONC_CALC, PARA_X,PARA_Y,POIDS#
L’utilisateur dispose de 2 modes de saisie pour renseigner les données expérimentales et les noms des tables et des colonnes des résultats calculés.
Il a le choix entre utiliser :
RESU_EXPet RESU_CALC et éventuellement LIST_POIDS qui nécessitent la saisie de listes python,
les mot-clés FONC_EXP, NOM_FONC_CALC, PARA_X, PARA_Y, POIDSdu mot-clé facteur COURBEqui ont l’avantage d’utiliser des concepts Aster.
◊ RESU_EXP
Nom de la liste Python de \(N\) tableaux numpy contenant les \(N\) courbes expérimentales. Pour un modèle statique la liste est définie préalablement sous la forme:
resu_exp=[
    numpy.array([[x0,y0], [x1,y1], ... [xn,yn]]),
    ...
    numpy.array([[u0,v0], [u1,v1], ... [un,vn]])
]
Pour le recalage d’un modèle dynamique avec des données expérimentales modales (fréquences et vecteurs propres), il s’agira du nom de la liste Python de \(N\) listes Python contenant les noms des tables et des colonnes contenant les réponses expérimentales. Par exemple:
resu_exp=[[‘REPEX1’,’NUM_ORDR’,’FREQ’],[‘REPEX2’,’NUM_ORDR’,’MAC_EXP’]]
◊ RESU_CALC
Nom de la liste de N listes Python contenant les noms des tables et des colonnes contenant les réponses numériques correspondant aux mesures expérimentales sur lesquelles on va effectuer le recalage. Par exemple:
resu_calc=[['TABLE1’,’INST’,’SIYY’], ['TABLE2’,’INST’,’V1’], ...]
◊ LIST_POIDS
Nom du tableau Numpy contenant les \(N\) poids à affecter aux \(N\) courbes expérimentales. Si le mot-clé n’est pas renseigné, alors chaque courbe a le même poids. La liste est définie préalablement sous la forme:
LIST_POIDS= numpy.array([p1, p2, ...])
◊ FONC_EXP
Nom de la fonction préalablement définie par l’opérateur DEFI_FONCTION qui correspond aux données expérimentales. Pour faire le lien avec RESU_EXP, la fonction fournie à ce mot-clé à l’itération \(i\) correspond au \(i\) ème tableau numérique de RESU_EXP.
   ◊    NOM_FONC_CALC

Chaîne de caractères correspondant au nom que l'on souhaite attribuer à la fonction après     recalage des données expérimentales.
   ◊    POIDS

Valeur du poids à affecter à la courbe expérimentale. Si non renseigné, alors la valeur est 1.
   ◊    PARA_X

Nom du paramètre :math:`X` de la fonction calculée.
   ◊    PARA_Y

Nom du paramètre :math:`Y` de la fonction calculée. Par exemple:
COURBE=(

_F(FONC_EXP=fct1, NOM_FONC_CALC='TABLE1',PARA_X='INST',PARA_Y='SIYY',),

_F(FONC_EXP=fct2, NOM_FONC_CALC='TABLE2',PARA_X='INST',PARA_Y='V1',),)
4.3. Opérandes LIST_PARA, PARA_OPTI, NOM_PARA, VALE_INI, VALE_MIN,VALE_MAX#
L’utilisateur dispose de 2 modes de saisie pour renseigner les noms et valeurs des paramètres.
Il a le choix entre utiliser :
LISTE_PARA qui nécessitent la saisie de listes python,
les mot-clés NOM_PARA, VALE_INI, VALE_MIN, VALE_MAXdu mot-clé facteur PARA_OPTI qui ont l’avantage d’utiliser des concepts Code_Aster (valeurs numériques ou chaînes de caractères).
◊ LIST_PARA
Nom de la liste Python de \(P\) listes Python contenant les noms des variables, leurs valeurs initiales, leurs valeurs minimales et leurs valeurs maximales. Cette liste est définie préalablement sous la forme:
List_para=[['PARA1__’, INI_1, MIN_1, MAX_1],
    [‘PARA2__’, INI_2, MIN_2, MAX_2],
    ....
    [‘PARAP__’, INI_P, MIN_P, MAX_P]]
Attention:
On demande que les noms des variables se terminent par deux blancs soulignés (par exemple: YOUN__).
Remarque:
Les bornes ne sont pas gérées par les algorithmes FMIN, FMINBFGS et FMINNCG.
◊ NOM_PARA
Nom du paramètre. La chaîne de caractère fournie à NOM_PARAà l’itération \(i\) correspond au premier élément de la \(i\) ème liste python de la liste fournie à LIST_PARA.
◊ VALE_INI
Valeur initiale du paramètre. Le réel fourni à NOM_PARAà l’itération \(i\) correspond au second élément de la \(i\) ème liste python de la liste fournie à LIST_PARA.
◊ VALE_MIN
Valeur minimale du paramètre. Le réel fourni à NOM_PARAà l’itération \(i\) correspond au troisième élément de la \(i\) ème liste python de la liste fournie à LIST_PARA.
◊ VALE_MAX
Valeur maximale du paramètre. Le réel fourni à NOM_PARAà l’itération \(i\) correspond au quatrième élément de la \(i\) ème liste python de la liste fournie à LIST_PARA.
4.4. Opérande UNITE_RESU#
◊ UNITE_RESU
Numéro d’unité logique du fichier de résultat du recalage (évolution des paramètres au cours des itérations, critères de convergence).
4.5. Opérande ITER_MAXI#
◊ ITER_MAXI
Nombre d’itérations maximales de recalage.
4.6. Opérande ITER_FONC_MAXI#
◊ ITER_FONC_MAXI
Nombre d’évaluations maximales de la fonctionnelle.
4.7. Opérande RESI_GLOB_RELA#
◊ RESI_GLOB_RELA
Résidu global relatif du recalage.
Cette valeur est disjointe de celle renseignée pour les solveurs non linéaires STAT_NON_LINE et DYNA_NON_LINE.
4.8. Opérande TOLE_FONC#
◊ TOLE_FONC
Critère d’arrêt de l’algorithme de recalage basé sur la variation de la fonctionnelle d’une itération à l’autre. Ce critère correspond à la valeur absolue de la norme de ma fonctionnelle.
4.9. Opérande TOLE_PARA#
◊ TOLE_PARA
Critère d’arrêt de l’algorithme de recalage basé sur la variation des paramètres d’une itération à l’autre. Ce critère correspond à la norme \(\mathit{L2}\) : racine carrée de la somme des carrés des différences de chaque paramètres.
4.10. Opérande PARA_DIFF_FINI#
◊ PARA_DIFF_FINI
Le recalage nécessite le calcul des dérivées des réponses par rapport aux paramètres.
Ce calcul est réalisé par différences finies. PARA_DIFF_FINIES correspond à \(\alpha\) dans la formule suivante:
\(\frac{\partial f}{\partial x}\approx \frac{f(x+\alpha x)-f(x)}{\alpha x}\)
4.11. Opérande GRAPHIQUE#
◊ UNITE
Numéro d’unité logique des graphiques produits au cours du recalage. A chaque itération, MACR_RECAL produit \(N\) fichiers graphiques (dont le format est défini par le mot-clé PILOTE) représentant les \(N\) courbes expérimentales et calculées.
◊ PILOTE
Type d’affichage des graphiques.
Si PILOTE = “INTERACTIF” ou “INTERACTIF_BG”, xmgrace est ouvert de façon interactive avec le graphique. Avec “INTERACTIF_BG”, xmgrace est appelé en arrière plan, le calcul se poursuit.
Si PILOTE vaut “POSTSCRIPT”,”EPS”, “MIF”, “SVG”, “PNM”, “PNG”, “JPEG” ou “PDF” alors xmgrace est utilisé pour générer le fichier de format correspondant, dans l’unité logique définie par UNITE.
Attention:
Le mode INTERACTIF n’est possible que lorsque le recalage tourne en interactif et non en batch.
◊ FORMAT
Choix du logiciel d’affichage des courbes en mode interactif: xmgrace ou gnuplot. L’utilisation d’Xmgrace est bloquante: il faut fermer la fenêtre Xmgrace pour continuer l’exécution.
◊ AFFICHAGE
Affichage des courbes à chaque itération ou uniquement à la fin.
4.12. Opérande METHODE#
◊ METHODE
Méthode ou algorithme d’optimisation choisi:
LEVENBERG (défaut) : algorithme de Levenberg-Marquardt. Cet algorithme est celui préconisé dans les problèmes de minimisation quadratique type moindres carrés, comme des problèmes de recalage de paramètres matériaux.
FMIN : Nelder-Mead Simplex algorithm (n’utilise que des estimations de la fonctionnelle).
FMINBFGS : méthode Quasi-Newton (utilise la fonctionnelle et le gradient de la fonctionnelle).
FMINNCG : méthode Line-search Newton Conjugate Gradient (utilise la fonctionnelle, le gradient de la fonctionnelle et son hessien).
GENETIQUE: algorithme évolutionnaire basé sur le mécanisme de la sélection et du remplacement. C’est un algorithme qui coute cher en temps CPU, on conseille son utilisation seulement pour une exploration grossière de l’espace des paramètres dans le cadre de la technique hybride de recalage présentée dans le point suivant.
HYBRIDE: technique qui combine le stochastique avec le déterministe - l’algorithme évolutionnaire avec l’algorithme de Levenberg – Marquardt
Le mode EXTERNE : cette méthode permet d’utiliser un algorithme d’optimisation externe à Code_Aster , par exemple Matlab ou Scilab, et d’utiliser Code_Aster uniquement pour l’estimation de la fonctionnelle et éventuellement du gradient par différences finies. Ce n’est pas un mot-clé de MACR_RECAL car le mode EXTERNE s’utilise directement par l’appel du fichier bibpyt/Macro/recal.py
Concernant le choix de l’algorithme d’optimisation , il est fortement conseillé d’opter pour l’algorithme par défaut, Levenberg-Marquardt . Celui-ci est très souvent supérieur aux algorithmes FMIN* pour des problèmes de minimisation de type moindres carrés, comme le recalage de paramètres. En effet, il utilise la fonctionnelle sous sa forme vectorielle alors que les autres algorithmes utilisent une fonctionnelle scalaire, par conséquent moins riche. De plus, il utilise une méthode de contraintes actives afin de gérer des bornes sur les paramètres, alors que les autres algorithmes ne gèrent pas les bornes.
Les autres algorithmes peuvent néanmoins être utiles dans les cas où Levenberg-Marquardt est mis en difficulté. Par exemple, l’algorithme FMIN n’utilise pas de gradients, dont l’évaluation peut dans certains cas très particuliers générer des problèmes numériques (paramètres très sensibles, trop peu de valeurs expérimentales, ou autres). L’algorithme FMIN est nettement plus lent, mais pourra arriver à converger (pour faire un parallèle, la problématique est similaire à celle d’utiliser la matrice élastique à la place de la matrice tangente dans STAT_NON_LINE).
Pour l’algorithme de Levenberg-Marquardt, le document [R4.03.06] décrit plus précisément l’algorithmie mathématique mise en jeu.
Les algorithmes FMIN* ont été repris intégralement d’un module Python distribué sur Internet (http://pylab.sourceforge.net) sous licence GPL par Travis E. Oliphant, par ailleurs contributeur principal du projet Python-Scipy et responsable du module d’optimisation de Scipy. Les détails d’algorithmie et d’implémentation peuvent être trouvés sur la page http://pylab.sourceforge.net.
La méthode HYBRIDE est conseillée lorsqu’on a un degré élevé d’incertitude sur les valeurs optimales des paramètres ou lorsque la fonctionnelle présente des nombreuses minima locaux. Ainsi, dans le cadre de cette méthode, on lance d’abord une recherche grossière avec l’algorithme évolutionnaire, ce qui permettra d’éviter les minima locaux, suivi par un affinement de l’optimisation avec l’algorithme de Levenberg-Marquardt.
4.13. Mot-clé CALCUL_ESCLAVE#
4.13.1. Opérande LANCEMENT#
◊ LANCEMENT
Méthode de lancement des fichiers esclaves : inclusion ou distribution. Les deux modes ont des avantages et des inconvénients et le choix de l’un ou de l’autre dépend principalement des temps de calculs des fichiers esclaves, ainsi que de leur compatibilité avec le mode Inclusion.
4.13.2. Opérande INCLUSION#
◊    INCLUSION

Dans ce mode, le fichier esclave est inclus. Il n'y a donc pas de perte de temps pour la génération d'une nouvelle étude, la création du répertoire temporaire d'exécution, etc.. En contre-partie, seule une étude esclave pourra passer en même temps sur la machine. D'autre part, certaines études esclaves (par exemple celles utilisant des fichiers de données inclus, ou des profils d'exécution un peu complexes) ne sont pas compatibles.
Remarque:
Dans le mode INCLUSION, la commande Aster INCLUDE ne peux pas être présente dans le fichier esclave (incompatibilité avec le superviseur Aster).
Il faut donc remplacer la commande:
INCLUDE(UNITE=n)
par la commande:
execfile(fort.n)
où n est l’unité logique du fichier à inclure.
4.13.3. Opérande DISTRIBUTION, MODE, MEMOIRE, TEMPS, CLASSE, UNITE_SUIVI#
◊    DISTRIBUTION

Dans ce mode, à chaque itération de l'algorithme d'optimisation, les :math:`N+1`calculs esclaves (pour un recalage de :math:`N`paramètres) sont exécutés en parallèles, en batch ou en interactif, en utilisant le module de calculs distribués d'as_run. Comparé au mode Inclusion, chaque étude est légèrement plus longue à s'exécuter, car il faut régénérer une nouvelle étude Code_Aster, créer les fichiers temporaires, etc.. En revanche, comme les études sont lancées en parallèles, suivant les caractéristiques des études esclaves (taille et durée), plus le nombre de paramètres est grand et plus le mode Distribué prend de l'intérêt sur le mode Inclusion.


En mode distribué, des paramètres supplémentaires sont disponibles pour contrôler les exécutions des calculs esclaves :
◊    MODE : INTERACTIF ou BATCH
◊    MEMOIRE : mémoire en Mo
◊    TEMPS : temps en secondes
◊    CLASSE : classe de batch, permet de forcer les calculs à utiliser une classe spécifique, par exemple «distr» sur le serveur Code_Aster
◊    UNITE_SUIVI : si ce mot-clé est préciser, il défini l'unité logique du fichier du profil dans lequel seront stockés tous les fichiers output des jobs esclaves
◊    NMAX_SIMULT: nombre de calculs esclaves lancés en parallèle en mode distribution (si aucune valeur n'est renseigné, le code décide automatiquement de ce nombre)


Il est possible d'utiliser le parallélisme MPI pour les études esclaves. Dans ce cas, il est nécessaire de lancer le calcul maître avec une version MPI et sur un seul processeur (en mode interactif ou en batch). Les caractéristiques MPI des calculs esclaves doivent être indiquées par les mot-clés suivants:
◊    MPI_NBCPU: nombre de processeurs MPI pour chacun des calculs esclaves lancés en parallèle
◊    MPI_NBNOEUD: nombre de nœuds pour chaque calcul esclave lancé en parallèle


A noter que des problèmes d'exploitation peuvent venir perturber le lancement des calculs esclaves distribués (par exemple, les classes de batch sont mal définies et les calculs ne peuvent s'exécuter). Dans ce cas, l'erreur obtenue dans le .mess du calcul maître peut être assez sobre (un message d'erreur du style «au moins un des calculs esclaves n'a pas pu démarrer»). Pour obtenir des informations supplémentaire concernant le module distribué d'as_run, il faut mettre simultanément UNITE_SUIVI et INFO=2.
4.14. Opérandes NB_PARENTS et NB_FILS#
◊ NB_PARENTS
Pour la méthode GENETIQUE ou HYBRIDE, cet opérande défini la taille de la population des paramétrés. Initialement tous les individus sont identiques et initialisés avec les valeurs initiales des paramètres fournies par l’utilisateur dans LIST_PARA. Au cours de l’optimisation la population évolue, les individus les moins «adaptés» étant remplacés par des par d’autres qui ont fourni une meilleure valeur de la fonctionnelle.
◊ NB_FILS
Représente le taux de remplacement de la population. Plus exactement, le meilleur «parent» (celui pour lequel la valeur de la fonctionnelle est minime) a le droit de se reproduire générant donc NB_FILS «fils». A ce moment la taille de la population est NB_PARENTS+NB_FILS. Suivant hiérarchie des valeurs de la fonctionnelle, seuls les meilleurs individus de toute cette population sont retenus et on revient à la taille initiale: NB_PARENTS.
4.15. Opérande ECART_TYPE#
◊ ECART_TYPE
C’est la valeur de l’écart type que l’utilisateur impose pour les tirages au sort quasi-aléatoires des «fils». Plus on veut explorer l’espace topologique des paramètres, plus il faut augmenter cette valeur. Corroboré à la taille de la population et au taux de remplacement, cet opérant permet de piloter l’algorithme évolutionnaire suivant la complexité du modèle et le degré d’incertitude sur les valeurs optimales des paramètres. Si on connaît peu de choses sur les valeurs des paramètres à recaler, il est recommandable d’utiliser une taille élevée de la population, un taux de remplacement également élevé et un écart type grand. La contrepartie sera un temps CPU très élevé.
4.16. Opérande ITER_ALGO_GENE#
◊ ITER_ALGO_GENE
Nombre d’itérations maximales pour l’algorithme évolutionnaire. Si on utilise la méthode HYBRIDE, cette valeur (ou RESI_ALGO_GENE) va déterminer le passage à l’algorithme de Levenberg-Marquardt.
4.17. Opérande RESI_ALGO_GENE#
◊ RESI_ALGO_GENE
Résidu relatif du recalage l’algorithme évolutionnaire. Si on utilise la méthode HYBRIDE, cette valeur (ou ITER_ALGO_GENE) va déterminer le passage à l’algorithme de Levenberg-Marquardt.
4.18. Opérande GRAINE#
◊ GRAINE
Valeur imposée par l’utilisateur pour la graine du générateur des tirages au sort dans l’algorithme évolutionnaire. Si on renseigne une valeur pour ce mot-clé, on force le générateur de nombres aléatoires présent dans l’algorithme évolutionnaire de générer toujours les mêmes tirages au sort, donc on aura une répétition de la solution. Son emploi est réservé seulement aux cas-tests pour des raisons de suivi de la non-régression du code.
4.19. Opérande DYNAMIQUE#
On renseigne cet opérande pour le recalage des paramètres d’un modèle dynamique par analyse modale.
◊ MODE_EXP
Nom du concept mode_meca qui contient les données modales expérimentales. Ce concept est extrait dans le calcul esclave par un LIRE_RESU.
◊ MODE_CALC
Nom du concept mode_meca qui contient les données modales numériques. Ce concept est calculé dans le fichier esclave par un CALC_MODES.
◊ APPARIEMENT_MANUEL
Choix d’afficher en mode interactif d’une fenêtre graphique qui permettra d’apparier manuellement les modes propres. On évite ainsi par exemple l’appariement mauvais automatique des modes propres double croisés.
La capture d’écran présentée dans la Figure 4.19-a illustre cette fenêtre graphique.
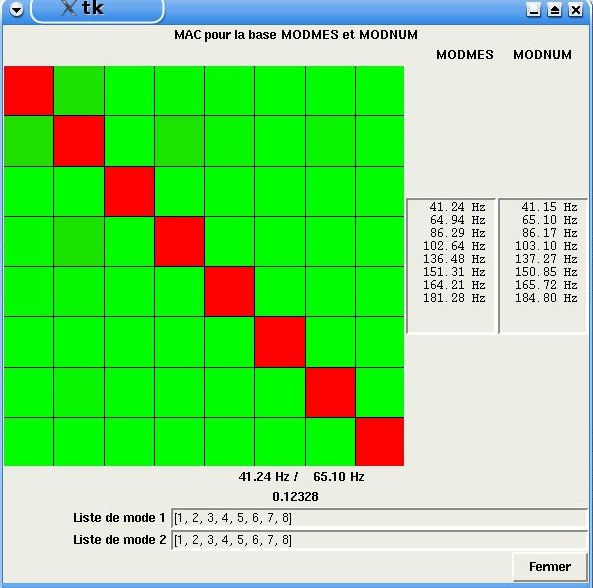
Figure 4.19-a. Fenêtre graphique pour l’appariement manuel des MAC
L’utilisateur voit ainsi, à chaque génération de l’algorithme évolutionnaire ou à chaque itération de l’algorithme de Levenberg-Marquardt, la matrice de MAC et il peut décider de changer d’appariement en modifiant l’ordre des modes dans les listes situées en bas de la fenêtre. Cette fenêtre est bloquante pour l’exécution des commandes Code_Aster donc il faut la fermer pour que le processus de recalage continue. La fermeture de la fenêtre en cliquant sur le bouton Fermer permet de récupérer les nouvelles listes des modes dont l’ordre a été éventuellement modifiée par l’utilisateur.
4.20. Opérande GRADIENT#
◊ GRADIENT
Pour les méthodes FMINBFGS, FMINNCG ou EXTERNE, ce mot-clé permet d’indiquer à Code_Aster la façon de calculer les gradients (adimensionné ou non), ou bien de ne pas les calculer.
Note : pour les algorithmes qui utilisent les gradients, ceux-ci peuvent être calculés par différences finies automatiquement par Code_Aster , ou bien calculés dans le fichier esclave en utilisant, par exemple des calculs de sensibilité (mot-clé LIST_DERIV).