1. Le parallélisme en quelques clics !#
1.1. Pourquoi ?#
Souvent une simulation Code_Aster peut bénéficier de gains importants de performance en distribuant ses calculs sur plusieurs cœurs d’un PC ou sur un ou plusieurs nœuds d’une machine centralisée.
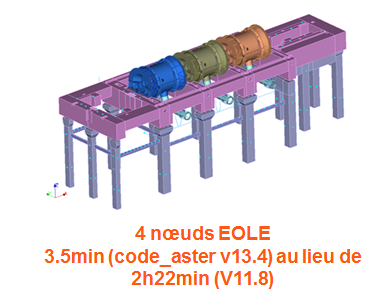
On peut gagner en temps (avec le parallélisme MPI et avec le parallélisme OpenMP) comme en mémoire (seulement via MPI). Ces gains sont variables suivant les fonctionnalités sollicitées, leurs paramétrages, le jeu de données et la plate-forme logicielle utilisée: cf. figure 1.1.
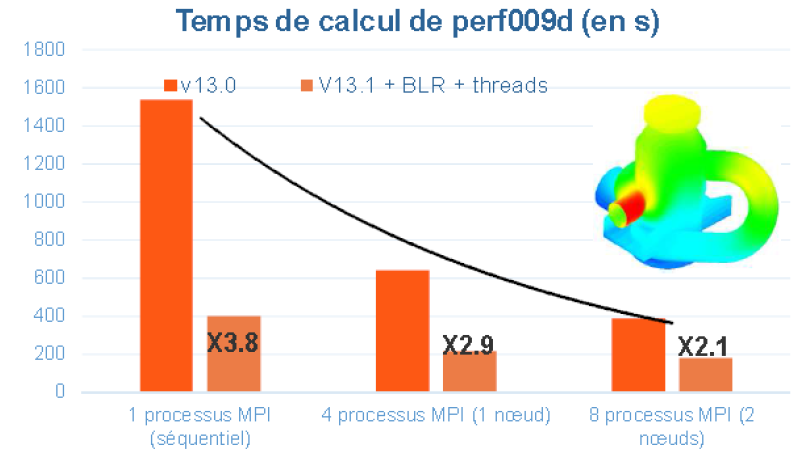
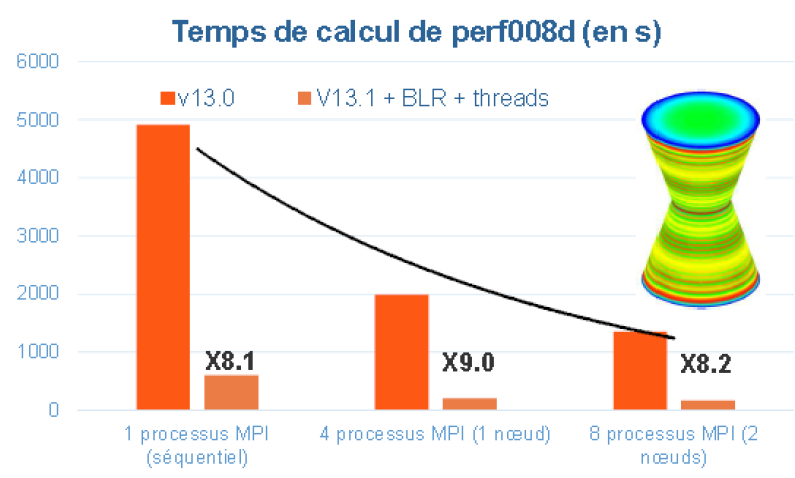
Figure 1.1._ Exemple de gains en temps procurés par le parallélisme MPI de Code_Aster v13.0, et avec celui hybride MPI+OpenMP (+ compressions low-rank cf. [U4.50.01]) de Code_Aster v13.1. Comparaisons effectuées sur les cas-tests de performance perf008/9d et sur la machine centralisée Aster5.
1.2. Comment ?#
Dans Code_Aster, par défaut, le calcul est séquentiel. Mais on peut activer différentes stratégies de parallélisation . Celles-ci dépendent de l’étape de calcul considérée et du paramétrage choisi. Elles sont souvent chainables ou cumulatives. On peut ainsi initier des schémas parallèles comportant jusqu’à 3 niveaux de parallélisme imbriqués.
On a quatre grandes classes de problèmes parallélisables, la seconde étant la plus courante.
Soit la simulation peut s’organiser en plusieurs sous-calculs code_aster indépendants; 1 seul niveau de parallélisme est activable (MPI, cf. §4.1).
Soit ce n’est pas la cas mais:
celle-ci reste dominée par des calculs linéaires ou non linéaires (opérateurs STAT/DYNA/THER_NON_LINE, MECA_STATIQUE…); deux niveaux de parallélisme sont activables (MPI et OpenMP, cf. §4.2/4.3/5 et figures 1.2a/b).
celle-ci reste dominée par des calculs modaux divisibles en sous-bandes fréquentielles (INFO_MODE/CALC_MODES+”BANDE”); trois niveaux de parallélisme sont activables (MPI, MPI et threads, cf. §4.4 et 4.2/4.3/5 et figures 1.3a/b).
celle-ci reste dominée par des calculs MISS3D (CALC_MISS) indépendants (option FICHIER_TEMPS) ou non (autre option)(cf.§4.5 et figures 1.4a/b). La première catégorie admet jusqu’à deux niveaux de parallélisme (MPI et OpenMP), la seconde un seul (OpenMP).
Pour avoir une estimation du temps passé par un opérateur et donc des étapes prédominantes d’un calcul, on peut activer le mot-clé MESURE_TEMPS des commandes DEBUT/POURSUITE[U1.03.03] sur une étude type (éventuellement raccourcie ou expurgée).
Dans tous les cas, on conseillera de diviser les plus gros calculs en différentes étapes afin de séparer celles purement calculatoires [3]_ , de celles concernant des affichages , des post-traitements et des manipulations de champs [4]_ .
Une simulation code_aster peut d’ailleurs être organisée en plusieurs sous-calculs chaînés (mode POURSUITE). Chacun de ces sous-calculs peut même appartenir à une des catégorie précédente. Par exemple une simulation pourrait comporter une première partie dominée par un STAT_NON_LINE(cas de figure 2), suivie d’une poursuite centrée sur des CALC_MODES(cas de figure 3), elle-même chaînée à un calcul MISS3D (cas de figure 4).
Chacune de ces «poursuites» pourrait être lancée avec un paramétrage parallèle différent afin de profiter au mieux des ressources machines disponibles afin de les accélérer. Ou, au contraire, on pourra choisir un paramétrage parallèle «médian», qui restera constant pour chaque partie de l’étude et qui produira des performances intéressantes mais minorées.
Dans le premier cas de figure , on se référera à l’usage dédié de l’outil Astk (cf. §4.1 et [U2.08.07]).
Dans le second cas de figure , il faut commencer par repérer les résolutions de systèmes linéaires dans le fichier de commande (mot-clé SOLVEUR) et modifier leurs paramétrages afin d’utiliser un solveur linéaire HPC [U4.50.01]. Pour ce faire, on spécifie la valeur “MUMPS” ou “PETSC” au mot-clé METHODE.
On distribue ensuite, sur les processus MPI, les étapes de construction et celles de résolution de systèmes linéaires (cf. §4.2/5.2/5.3). Cela permet de baisser le niveau de mémoire requis et d’accélérer la simulation (cf. figures 1.2a/b).
On peut rajouter un deuxième niveau de parallélisme en utilisant, pour chaque processus MPI, plusieurs threads OpenMP (cf. §4.3). Ce second niveau n’accélère, par contre, qu’une partie de la résolution des systèmes linéaires et il ne permet pas de baisser le pic en mémoire RAM.
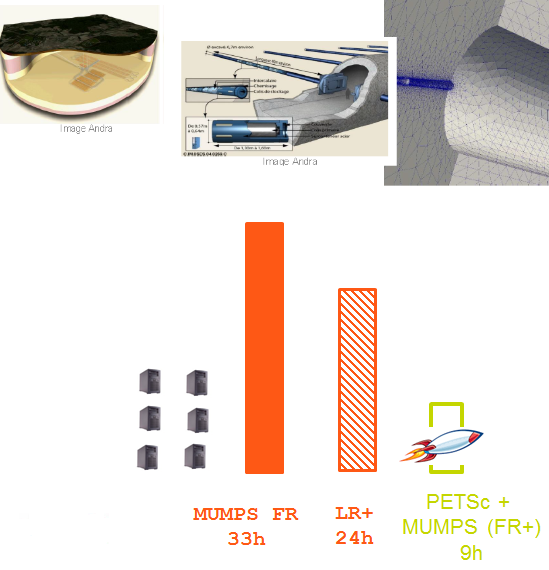
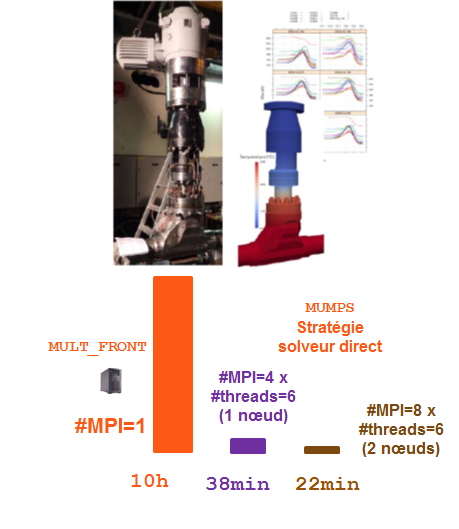
Figure 1. 2a ._ Exemple s d’ apport du HPC sur des portions d’études industrielles: (à gauche) rendre possible des simulations de dimensionnement de galerie de stockage (N=5M ddls, géométrie complexe, couplage fort thermo-hydro-mécanique); (à droite) accélérer d’un facteur X30 les chaînages thermo-mécaniques complexes des calculs de robinetterie (N=1M ddls, centaines de pas de temps, chocs thermiques, contacts, plasticité…).
Exemple:
Ainsi, un calcul comportant un modèle éléments finis conduisant à des systèmes linéaires de taille N=10 6 peut être par exemple parallélisé sur 8 MPI; Chaque processus MPI appelant lui-même 6 threads OpenMP. Donc, au tot al, le calcul requiert 8 x 6 = 48 c œ urs, soit, a vec des nœuds à 24 c œ urs, 2 nœuds.
D’où le paramétrage Astksuivant pour une utilisation proportionnée des ressources machine et une activation efficace des deux niveaux de parallélisme possibles (MUMPS/PETSc+ BLAS): ncpus=6, mpi_nbcpu=8 et mpi_nbnœud=2.
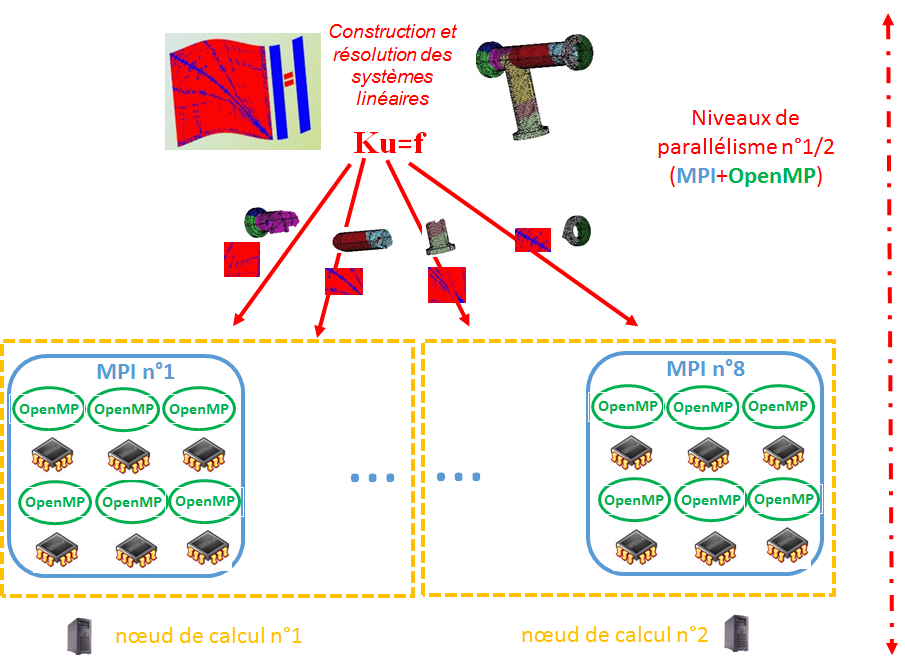
Figure 1. 2b *._* Deux niveaux de parallélisme imbriqués dans les constructions et les résolutions
des systèmes linéaires (MPI et OpenMP).
Dans le troisième cas de figure , on distribue les calculs modaux sur plusieurs nœuds (cf. §4.4), en réservant plusieurs blocs de processus MPI. Chacun va traiter une sous-bande fréquentielle. Puis, en utilisant le solveur linéaire MUMPS, on peut rajouter un deuxième niveau MPI de parallélisation au sein de chacun de ses blocs (cf. cas de figure précédent). On peut éventuellement rajouter un troisième niveau en activant des threads OpenMP au sein de chaque processus MPI de résolution (cf. §4.3 et figures 1.3a/b).
Notons que l’efficacité de cette stratégie requiert des bandes fréquentielles assez bien équilibrées. Pour calibrer ces bandes, il est conseillé d’utiliser préalablement l’opérateur INFO_MODE[U4.52.01]. Lui aussi bénéficie d’un parallélisme MPI à deux niveaux très performant.
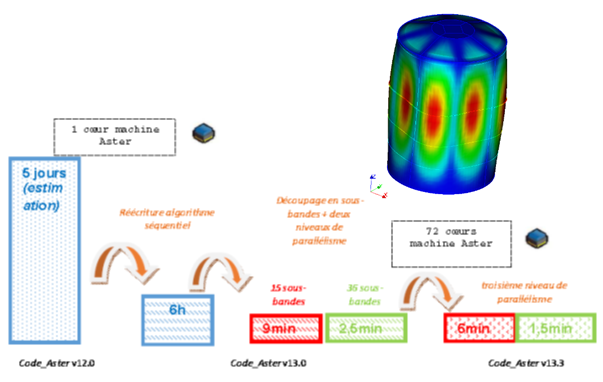
Figure 1. 3a ._ Exemple s d’ apport du HPC sur des portions d’études industrielles en dynamique: (à gauche) accélération X40 pour les diagnostics vibratoires sur des modèles GTA 3D (N=2.5M ddls, 80 modes) et (à droite) X4000 sur les calculs d’Interaction Fluide-Structure sur bâche PTR (N=50000 ddls, 6100 modes).
Exemple:
Ainsi un calcul sur quatre sous-bandes, chacune comportant une c entaine de modes propres de taille N=10 6 , peut être parallélisé sur 4 x 8 =32MPI (4 pour les sous-bandes et 8 pour chaque appel MUMPS au sein de ces sous-bandes). Chaque processus MPI pouvant appel er lui-même 6 threads OpenMP. Donc, au tot al, le calcul requiert 32x 6 = 192 c œ urs, soit, sur des nœuds à 24 c œ urs, 8 nœuds.
D’où le paramétrage Astksuivant pour une utilisation proportionnée des ressources machine et une activation efficace des trois niveaux de parallélisme possibles (CALC_MODES+ MUMPS+ BLAS): ncpus=6, mpi_nbcpu=32 et mpi_nbnœud=8.
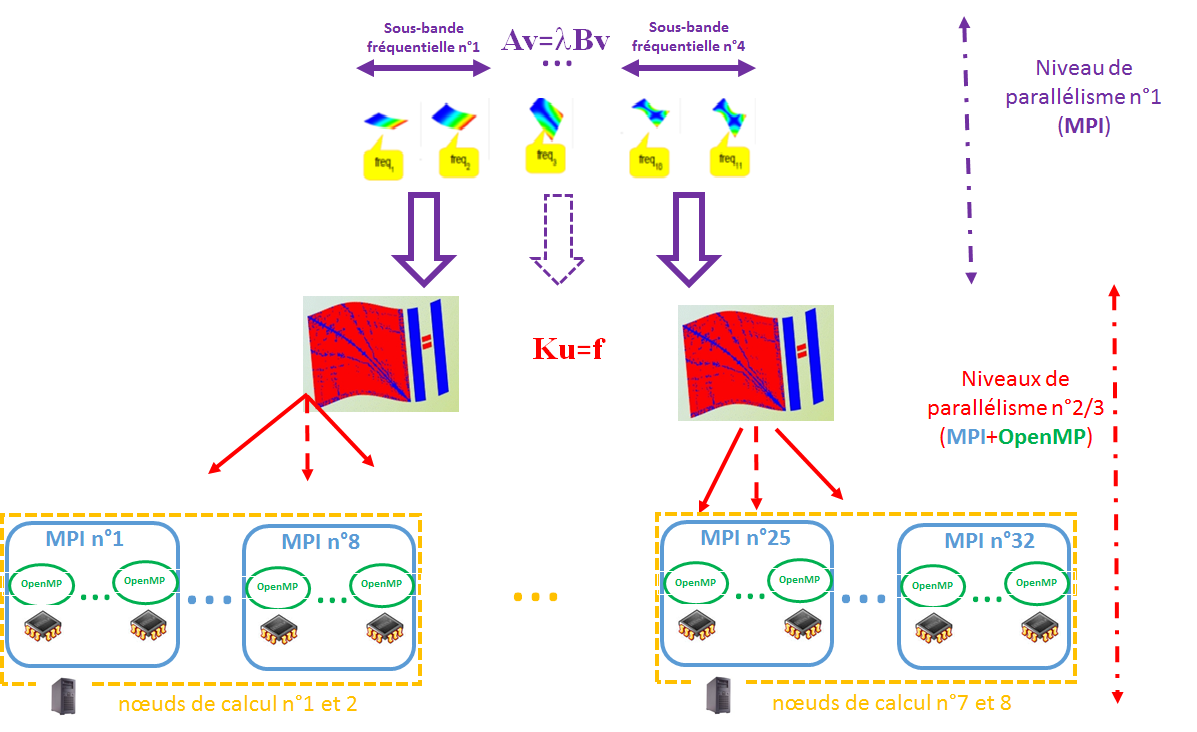
Figure 1. 3b *._* Jusqu’à trois niveaux de parallélisme imbriqués dans les calculs modaux (MPI, MPI et OpenMP).
Dans le quatrième cas de figure , si les calculs CALC_MISS sont indépendants (option FICHIER_TEMPS), on peut déjà les distribuer sur plusieurs nœuds, en réservant plusieurs processus MPI par nœud. Chacun va traiter une série de fréquences. On ne prendra pas tous les c œ urs d’un nœud afin de laisser assez de mémoire RAM au calcul MISS3D.
Ensuite, afin d’utiliser au mieux ces cœurs inoccupés, il est alors conseillé de rajouter un deuxième niveau de parallélisme en activant des threads OpenMP au sein de chaque processus MPI MISS3D (cf. §4.5 et figures 1.4a/b).
Si les calculs ces calculs CALC_MISS ne sont, par contre, pas indépendants (autre option que FICHIER_TEMPS), on n’utilisera qu’un nœud du cluster et on n’activera que le second niveau de parallélisme via OpenMP.
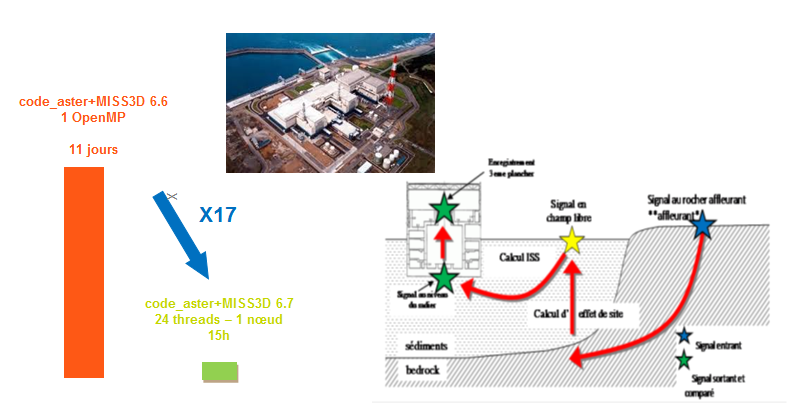
Figure 1. 4a ._ Exemple s d’ apport du HPC sur des portions d’études industrielles avec MISS3D: accélération X17 pour les réévaluations sismiques du benchmark Kashiwaski-Kariwa (14000 nœuds d’interface, 100 fréquences).
Exemple:
Ainsi, pour un calcul de160 fréquences parallélisé sur 8MPI , c haque processus MPI va traiter vingt fréquences et chacune d’entre-elle va elle-même pouvoir être parallélisée sur6 threads OpenMP. Donc, au tot al, le calcul requiert 8 x 6 = 48 c œ urs, soit, sur des nœuds à 24 c œ urs, 2 nœuds.
D’où le paramétrage Astksuivant pour une utilisation proportionnée des ressources machine et une activation efficace des deux niveaux de parallélisme possibles (CALC_MISS+ thread OpenMP): ncpus=6, mpi_nbcpu=8 et mpi_nbnœud=2.
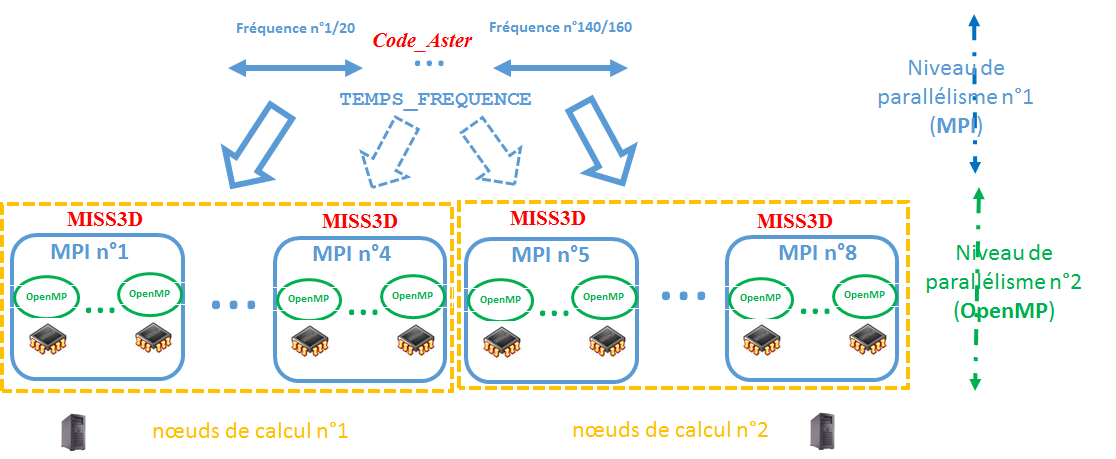
Figure 1. 4b *._* Jusqu’à deux niveaux de parallélisme imbriqués dans les couplages Code_Aster-MISS3D (MPI et OpenMP).
Remarque:
D’autres portions algorithmiques du code peuvent bénéficier du parallélisme (opérations d’algèbre linéaire basiques, étapes d’appariement de certains algorithmes de contact…). Ce parallélisme est en général automatique et non directement paramétrable. Il accompagne les 4 stratégies de parallélisme détaillées précédemment.
1.3. En pratique via Astk#
Pour la mise en œuvre effectives des cas de figure n°2, 3et n°4 , il faut pré-sélectionner une version parallèle de Code_Aster (notée **_mpi), puis préciser le nombre de c *œ urs retenus (menu Options d’A stk ) via les champs suivants:
(facultatif) ncpus=k , nombre de threads alloués en OpenMP par processus MPI; généralement utilisé en complément de MPI; valeur paramétrée par défaut si on ne rempli par le champ et qu’il reste vide.
mpi_nbcpu=m , nombre de processus MPI alloués au total (somme sur tous les nœuds).
mpi_nbnœud=p , nombre de nœuds sur lesquels vont être distribués ces m x k tâches parallèles.
On conseille en générale de ne pas allouer tous les cœurs d’un nœud en MPI seul . Cela peut avoir pour effet de ralentir la simulation car, même si une partie des calculs s’en trouve accélérée du fait de sa distribution sur plus de cœurs, comme ceux-ci partagent certaines ressources mémoire (caches, bus), les accès aux donnéessont, eux, ralentis.
Pour utiliser plus efficacement et à 100% toutes les ressources allouées on conseille plutôt de panacheret d’équilibrer les parallélismes MPI et OpenMP (parallélisme hybride à 2 niveaux).
Pour rester efficace , il faut bien sûr veiller à ne pas dépasser les capacités physiquesdes plate-formes :
pas plus de threads OpenMP (ncpus) que de cœurs partageant une mémoire physique (24 sur Aster5 et 28 sur EOLE);
pas plus de processus MPI (mpi_nbcpu), multipliés éventuellement par le nombre de threads précédent, que de cœurs physiques disponibles: par nœud (24 sur Aster5 et 28 sur EOLE) et au total (taille de la machine);
respecter les contraintes du gestionnaire batch et, en particulier, les ressources maximums allouables par un seul utilisateur.
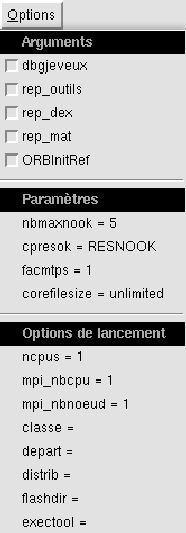
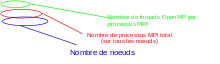
Figure 1. 5 ._ Paramètres d’Astk dédiés au parallélisme.
Les chapitres de ce document détaillent tous ces éléments. Une fois ceux-ci fixés, on peut lancer son calcul comme on le ferait en séquentiel (sur la machine centralisée, en mode batch uniquement). Sauf, qu’avec le parallélisme, on peut bien sûr réduire les spécifications en temps et en mémoire du calcul renseignées dans Astk (cf. [U1.03.03]).
Remarques:
Pour le seul parallélisme MPI des étapes de manipulation de systèmes linéaires (second cas de figure) il n’est pas utile d’allouer trop de processus. En général, la granularité de 1 processus MPI pour 30 ou 50 000 ddls est largement suffisante.
Si on souhaite continuer à accélérer le calcul, on peut initier un deuxième niveau de parallélisme et réduire cette granularité à quelques milliers de ddls par threads. Par exemple, un modèle comportant 0.6M ddls pourra très probablement bénéficier d’un parallélisme efficace en allouant 12 MPI x 5 threads OpenMP=60 cœurs.
Pour INFO_MODE ou CALC_MODES (troisième cas de figure), on commence par distribuer les sous-bandes, puis on tient compte du parallélisme éventuel du solveur linéaire (si usage deMUMPS ). Par exemple, pour un calcul modal comportant 8 sous-bandes, on peut poser mpi_nbcpu=32 *. Chacune des sous-bandes va alors utiliser* MUMPS sur 4 processus MPI. Et sur chacune de ces résolutions indépendantes on peut requérir le schéma parallèle précédent. Soit potentiellement trois niveaux de parallélisme imbriqués.
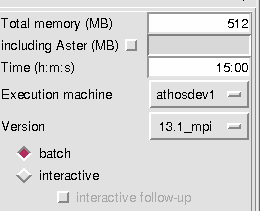
Figure 1. 6 ._ Paramètres d’Astk consacrés aux ressources en temps
et en mémoire RAM allouées (pour chaque processus MPI).
Par exemple, pour accélérer les constructions/résolutions de systèmes linéaires (cas de figure n°2 du paragraphe précédent), le fait de distribuer le calcul sur 12 processus MPI (mpi_nbcpu) permet généralement de diminuer d’au moins:
un facteur X2 le pic mémoire RAM (par processus MPI, cf. champ “Total memory” d’Astk figure 1.6),
un facteur X4 le temps d’exécution (temps dit “elapsed” ou temps d’attente «effectif» de retour du calcul, cf. champ “Time” d’Astk figure 1.6).
Et si on rajoute un niveau de parallélisme supplémentaire via 4 ou 6 threads OpenMP(ncpus) on peut encore gagner:
un facteur X2entemps d’exécution.