2. Généralités#
Toute simulation Code_Asterpeut bénéficier des gains de performance que procure le parallélisme. Du moment qu’il effectue des calculs élémentaires/assemblages, des résolutions de systèmes linéaires, de gros calculs modaux ou des simulations indépendantes/similaires. Les gains peuvent être de deux ordres : sur le temps de calcul et sur l’espace RAM/disque requis (par processus MPI).
Comme la plupart des codes généralistes en mécanique des structures, Code_Aster propose différentes stratégies pour s’adapter à l’étude et à la plate-forme de calcul. Une fois paramétrées, la plupart s’enchaînent et se couplent de manière automatique. Les paragraphes suivant en font le synoptique.
2.1. Parallélismes informatiques#
1a/Lancement de rampes de calculs indépendants/similaires (calculs paramétriques, tests…).
Outil: scriptage shell.
Gain : en temps elapsed.
Lancement: standard via Astk[U2.08.07].
Chaînage : aucun.
Cumul : possibles avec les autres schémas parallèles mais uniquement en usage avancé (surcharge de sources).
1b/Distribution des calculs élémentaires et des assemblages matriciels et vectoriels dans les pré/post-traitements et dans les constructions de systèmes linéaires. Parallélisme en mémoire distribuée.
Outil: langage MPI.
Gain : en temps elapsed, voire en pic mémoire RAM avec MUMPS+MATR_DISTRIBUEE.
Lancement: standard via Astk (mpi_nbcpu/mpi_nbnœud).
Chaînage : utile avec 2b ou 2c; possible mais peu utile avec 1c ou 1d seuls; possible mais inutile avec 2a.
Cumul : aucun.
1c/Distribution des calculs d’algèbre linéairebasiques (sous-étapes de MUMPS, bibliothèque BLAS) *.* Parallélisme en mémoire partagée activé uniquement avec le package MUMPS (cf. 2b) .
Outil: langage OpenMP.
Gain : en temps elapsed (mais augmentation du temps CPU).
Lancement: standard via Astk (ncpus).
Chaînage : possible mais peu utile avec 1b seul.
Cumul : contre-productif avec 2a, utile avec 2b, possible mais peu utile avec 2c ou 1d.
1d/Distribution des calculs modaux (resp. des calibrations modales) dans l’opérateur CALC_MODES (resp. INFO_MODE ). Parallélisme en mémoire distribuée (sans gain mémoire, uniquement accélération).
Outil: langage MPI.
Gain : en temps elapsed (mais augmentation du pic mémoire RAM à contrebalancer par le cumul avec 2b).
Lancement: standard via Astk (mpi_nbcpu/mpi_nbnœud).
Chaînage : possible mais peu utile avec 1b seul.
Cumul : utile avec 2b (voire 2b/1c); possible mais peu utile avec 2a; impossible avec 2c.
1e/Distribution des calculs MISS3D dans l’opérateur CALC_MISS . Parallélisme en mémoire distribuée (si OPTION=FICHIER_TEMPS) et/ou partagée (sans gain mémoire, uniquement accélération).
Outil: langages MPI et OpenMP.
Gain : en temps elapsed.
Lancement: standard via Astk (ncpus, mpi_nbcpu/mpi_nbnœud).
Chaînage : aucun.
Cumul : avec FICHIER_TEMPS deux niveaux de parallélisme possible, MPI x OpenMP.
1f/Autresdistributions de calculs: certaines étapes de l’algorithme de contact-frottement, opérateur REST_SPEC_TEMP. Parallélisme en mémoire distribuée (sans gain mémoire, uniquement accélération).
Outil: langages MPI.
Gain : en temps elapsed.
Lancement: standard via Astk (mpi_nbcpu/mpi_nbnœud).
Cumul : possible mais peu utile avec 1b (OpenMP).
2.2. Parallélismes numériques#
2a/Solveur direct MULT_FRONT ; Parallélisme en mémoire partagée.
Outil: langage OpenMP.
Gain : en temps elapsed (mais augmentation du temps CPU).
Lancement: standard via Astk (ncpus).
Chaînage : possible mais peu utile avec 1b, 2b ou 2c.
Cumul : contre-productif avec 1c, possible mais peu utile avec 1d.
2b/ PackageMUMPS (soit en tant que solveur direct, via METHODE=”MUMPS”, soit en tant que préconditionneur de PETSC/GCPC via PRE_COND=”LDLT_SP”).Parallélisme en mémoire distribuée.
Outil: langage MPI.
Gain : en temps elapsed et en pic mémoire RAM.
Lancement: standard via Astk (mpi_nbcpu/mpi_nbnœud).
Chaînage : utile avec 1b ou 2c, possible mais peu inutile avec 2a.
Cumul : utile avec 1c ou 1d.
2c/ Solveur itératifPETSC (avec éventuellement MUMPScomme préconditionneurcf. PRECOND=”LDLT_SP”); Parallélisme en mémoire distribuée.
Outil: langage MPI.
Gain : en temps elapsed et en pic mémoire RAM.
Lancement: standard via Astk (mpi_nbcpu/mpi_nbnœud).
Chaînage : utile avec 1b ou 2b, possible mais inutile avec 2a.
Cumul : possible mais peu utile avec 1c, hors-périmètre avec 1d.
Les schémas parallèles 1b+2b/1c ou 1b+2b+2c sont les plus plébiscités. Ils supportent une utilisation «industrielle» et «grand public». Ces parallélismes généralistes et fiables procurent des gains notables en CPU et en pic RAM par cœur. Leur paramétrisation est simple, leur mise en œuvre facilitée via Astk (cf. §1).
Pour une utilisation standard, l’utilisateur n’a plus à se soucier de la mise en œuvre fine du parallélisme . En renseignant les menus dédiés d’Astk [5]_ , on fixe le nombre de cœurs requis (pour le MPI et/ou l’OpenMP) ainsi que le nombre de nœuds sur lesquels ils se distribuent.
2.3. Parallélisation des systèmes linéaires#
Une fois ces portions de système linéaire construites (schéma parallèle 1b), deux cas de figures se présentent:
soit le traitement suivant est naturellement séquentiel et donc tous les processus MPI doivent avoir accès à l’information globale. Pour ce faire on rassemble ces bouts de systèmes linéaires et donc l’étape suivante ne sera ni accélérée, ni ne verra baisser ses consommations mémoire. Il s’agit le plus souvent d’une fin d’opérateur, d’un post-traitement ou d’un solveur linéaire non parallélisé en MPI (stratégie 1b+2a).
soit le traitement suivant accepte le parallélisme MPI , il s’agit alors principalement des solveurs linéaires HPC MUMPS (1b+2b), PETSC (1b+2c) ou les deux à la fois (1b+2b+2c). Le flot parallèle de données construit en amont leur est alors transmis (après quelques adaptations). Ces packages d’algèbre linéaire réorganisent ensuite, en interne, leurs propres schémas paralléles (avec une vision plus algébrique). On parle alors de schéma parallèle d’ordre plutôt «numérique». Cette combinaison «parallélisme informatique», au niveau de l’assemblage du système linéaire, et, «parallélisme numérique», au niveau de sa résolution, les 2 via MPI, est la combinaison la plus courante.
Remarques:
Notons qu’à l’issue du cycle «construction de système linéaire – résolution de celui-ci», quelque soit le scénario mis en œuvre (solveur linéaire séquentiel ou parallèle MPI), le vecteur solution est ensuite transmis, en entier, à tous les processus MPI. Le cycle peut ainsi continuer quelque soit la configuration suivante.
De plus, on peut superposer ou substituer à ce parallélisme MPI (qui fonctionne sur toutes les plate-formes), un autre niveau de parallélisme géré cette fois par le langage OpenMP . Celui-ci est cependant limité aux fractions de machine partageant physiquement la même mémoire (PC multi-cœurs ou nœuds de serveur de calcul).
Il ne permet pas de baisser les consommations mémoire mais par contre il accélère certains types de calcul et ce, avec une granularité plus faible que celle du MPI: il procure une meilleure accélération même si le flot de données/traitements n’est pas très important. C’est un schéma parallèle d’ordre «informatique» qui intervient principalement dans les opérations basiques d’algorithmes d’algèbre linéaire ( via par exemple la librairie BLAS).
Ce parallélisme peut être:
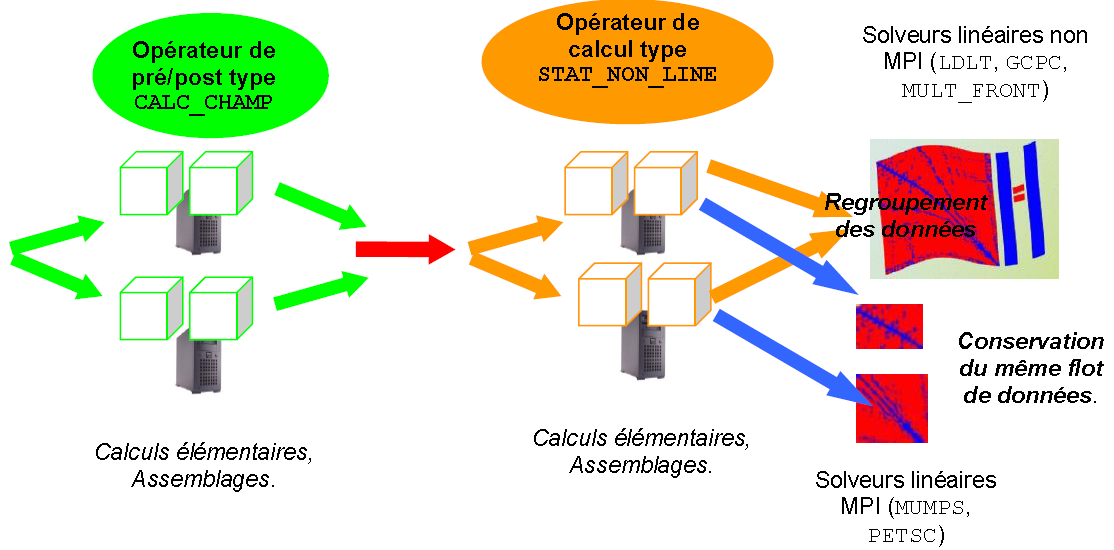
soit complémentaire du parallélisme MPI en accélérant les calculs au sein de chaque processus MPI (dans la partie résolution de système linéaire avec MUMPS, stratégie dite «2b/1c»).
soit se substituer au parallélisme MPI en accélérant la résolution de système linéaire avec MULT_FRONT (stratégie 2a).
Figure 2.3.1._ Organisation du schéma parallèle MPI
de construction et de résolution des systèmes linéaires.
2.4. Distribution de calculs modaux#
Lorsque la simulation ne peut pas se décomposer en calculs Aster indépendants, mais qu’elle reste dominée néanmoins par des calculs modaux généralisés (opérateurs INFO_MODE et CALC_MODES), on peut organiser un schéma parallèle spécifique.
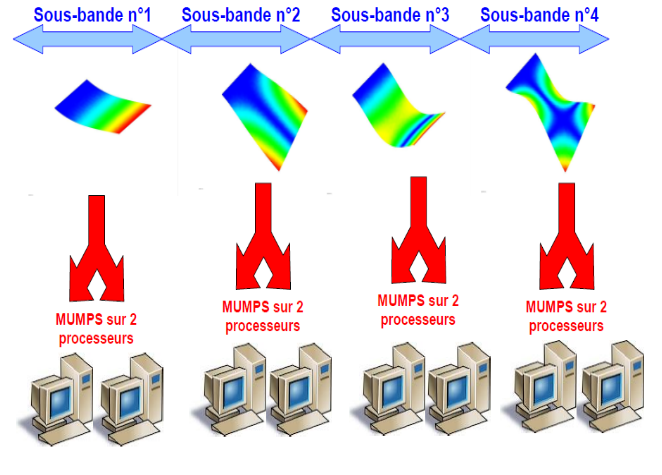
Il est fondé sur la distribution de calculs modaux indépendants: chacun étant en charge d’une sous-bande fréquentielle. Ce schéma parallèle d’ordre purement «informatique» ne procure que des gains en temps.
Il peut toutefois cohabiter avec les schémas parallèles précédents:
chaînage avec le parallélisme MPI de construction des systèmes linéaires (dans par exemple CALC_MATR_ELEM,stratégie 1b+1d),
cumul avec le parallélisme MPI (voire OpenMP) dans les résolutions de systèmes linéaires (si utilisation de MUMPS,stratégie à 2 niveaux de parallélisme, 1d/2b voire trois, 1d/2b/1c).
Figure 2.4.1._ Organisation du schéma parallèle MPI de distribution des calculs modaux et de résolutions des systèmes linéaires associés.
Remarque s :
Entre chaque commande, l’utilisateur peut même changer la répartition des mailles suivant les processeurs. Il lui suffit d’utiliser la commande MODI_MODELE. Ce mécanisme reste licite lorsqu’on enchaîne différents calculs (mode POURSUITE). La règle étant bien sûr que cette nouvelle répartition perdure, pour le modèle concerné, jusqu’à l’éventuel prochain MODI_MODELE et que cette répartition doit rester compatible avec le paramétrage parallèle du calcul (nombre de nœuds/processeurs…).
De toute façon, tout calcul parallèle Aster doit respecter les paradigmes suivant : en fin d’opérateur de calcul [6]_
, les bases globales de chaque processeur sont identiques [7]_ et le communicateur MPI courant est le communicateur standard ( MPI_COMM_WORLD ). Tous les autres éventuels sous-communicateurs MPI doivent être détruits.
Car on ne sait pas si l’opérateur qui suit dans le fichier de commandes a prévu un flot de données incomplet. Il faut donc organiser les communications idoines pour compléter les champs éventuellement incomplets.