5. Liens avec le parallélisme#
Nota: pour plus d’informations on pourra consulter la notice d’utilisation dédiée au parallélisme [U2.08.06].
5.1. Généralités#
Souvent une simulation Code_Aster peut bénéficier de gains importants de performance en distribuant ses calculs sur plusieurs cœurs d’un PC ou sur un ou plusieurs nœuds d’une machine centralisée.
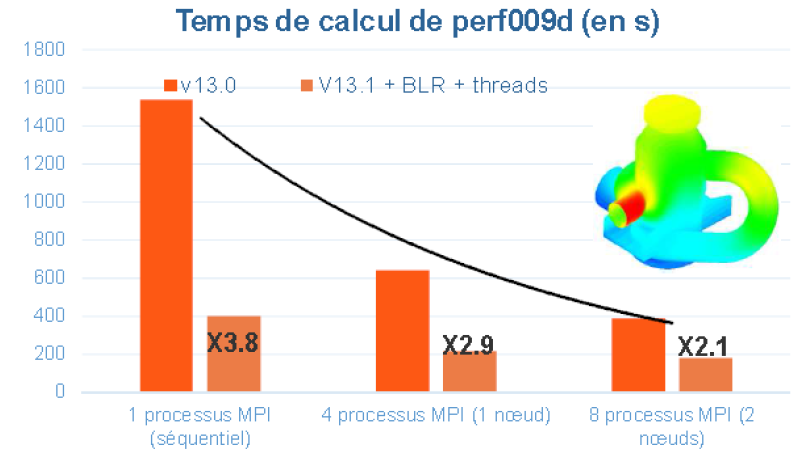
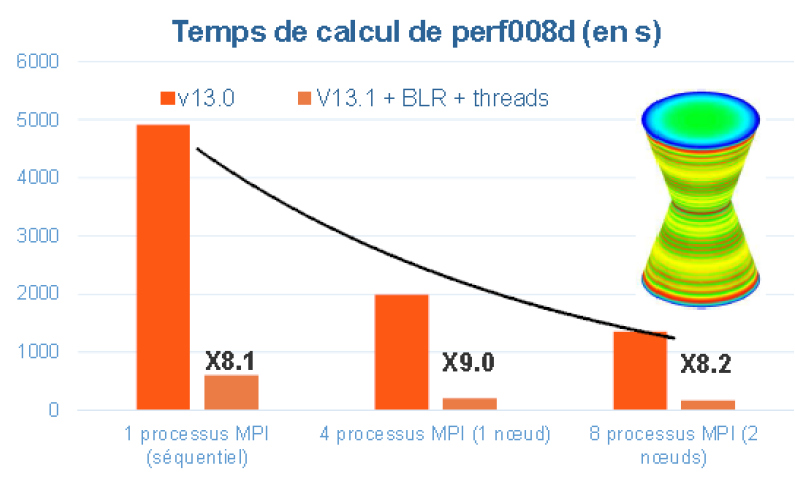
Figure 5.1.1._ Exemple de gains en temps procurés par le parallélisme MPI de Code_Aster v13.0, et avec celui hybride, MPI+OpenMP (+ compressions low-rank cf. [U4.50.01]) de Code_Aster v13.1. Comparaisons effectuées sur les cas-tests de performance perf008d et perf009d et sur la machine centralisée Aster5.
On peut gagner en temps (avec le parallélisme MPI et avec le parallélisme OpenMP) comme en mémoire (seulement via MPI). Ces gains sont variables suivant les fonctionnalités sollicitées, leurs paramétrages, le jeu de données et la plate-forme logicielle utilisée: cf. figure 5.1.1.
Dans Code_Aster, par défaut, le calcul est séquentiel. Mais on peut activer différentes stratégies de parallélisation . Celles-ci dépendent de l’étape de calcul considérée et du paramétrage choisi. Elles sont souvent cumulatives ou chaînables.
On a trois grandes classes de problèmes parallélisables, la seconde étant la plus courante:
soit la simulation peut s’organiser en plusieurs sous-calculs indépendants (cf. §5.2),
soit ce n’est pas la cas mais:
celle-ci reste dominée par des calculs linéaires ou non linéaires (opérateurs STAT/DYNA/THER_NON_LINE, MECA_STATIQUE… cf. §5.3),
celle-ci reste dominée par des calculs modaux divisibles en sous-bandes fréquentielles (INFO_MODE/CALC_MODES+”BANDE”, cf. §5.4).
Pour avoir une estimation du temps passé par un opérateur et donc des étapes prédominantes d’un calcul, on peut activer le mot-clé MESURE_TEMPS des commandes DEBUT/POURSUITE (cf. [U1.03.03]) sur une étude type (éventuellement raccourcie ou édulcorée).
Dans tous les cas, on conseillera de diviser les plus gros calculs en différentes étapes afin de séparer celles purement calculatoires [6]_ , de celles concernant des affichages , des post-traitements et des manipulations de champs [7]_ .
5.2. Calculs indépendants#
Lorsque la simulation peut s’organiser en différents sous-calculs Aster indépendants (cf. figure 5.2.1) , l’outil Astk[U1.04.00] propose une fonctionnalité adaptée (cf. [U2.08.07]). Celle-ci distribue ces sous-calculs sur différentes ressources machine et récupère leurs résultats. C’est un schéma parallèle complètement «informatique».
La limite étant, pour l’instant, que tous ces calculs unitaires doivent pouvoir s’exécuter chacun séquentiellement sur la machine choisie (ce qui peut parfois poser des problèmes de ressources mémoire, cf. [U4.50.01]).
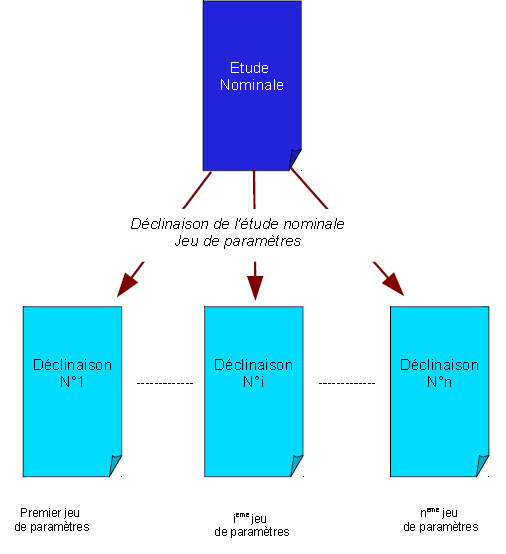
Figure 5.2.1._: Parallélisme des calculs indépendants.
5.3. Parallélisation des systèmes linéaires#
Lorsque cette simulation ne peut pas se décomposer en sous-calculs Aster similaires et indépendants, mais qu’elle reste dominée néanmoins par des calculs linéaires ou non linéaires (opérateurs STAT/DYNA/THER_NON_LINE, MECA_STATIQUE… cf. §5.3), on peut organiser un schéma parallèle spécifique.
Il est fondé sur la distribution des tâches et des structures de données impliquées dans les manipulationsde systèmes linéaires . Car ce sont ces étapes de construction et de résolution de systèmes linéaires qui sont souvent les plus sollicitantes en temps de calcul et en ressources mémoire. Elles sont présentes dans la plupart des opérateurs car elles sont enfouies au plus profond d’autres algorithmes «plus métiers»: solveur non linéaire, calcul modal et vibratoire, schéma en temps…
La première étape du schéma parallèle concerne la distribution des éléments finis du modèle sur tous les processus MPI. Chaque processus MPI ne va donc gérer que les traitements et les données associés aux éléments dont il a la charge. La construction des systèmes linéaires dans Code_Aster (calculs élémentaires, assemblages) s’en trouve alors accélérée. On parle souvent de « parallélisme en espace ». C’est un schéma parallèle plutôt d’ordre «informatique».
Une fois ces portions de système linéaire construites (cf. figure 5.3.1), deux cas de figures se présentent:
soit le traitement suivant est naturellement séquentiel et donc tous les processus MPI doivent avoir accès à l’information globale. Pour ce faire on rassemble ces bouts de systèmes linéaires et donc l’étape suivante ne sera ni accélérée, ni ne verra baisser ses consommations mémoire. Il s’agit le plus souvent d’une fin d’opérateur, d’un post-traitement ou d’un solveur linéaire non parallélisé en MPI (MULT_FRONT, LDLT, GCPC).
soit le traitement suivant accepte le parallélisme MPI , il s’agit alors principalement des solveurs linéaires HPC MUMPS et PETSC. Le flot parallèle de données construit en amont leur est alors transmis (après quelques adaptations). Ces packages d’algèbre linéaire réorganisent ensuite, en interne, leurs propres schémas paralléles (avec une vision plus algébrique). On parle alors de schéma parallèle d’ordre plutôt «numérique». Cette combinaison «parallélisme informatique», au niveau de l’assemblage du système linéaire, et, «parallélisme numérique», au niveau de sa résolution, les 2 via MPI, est la combinaison la plus courante.
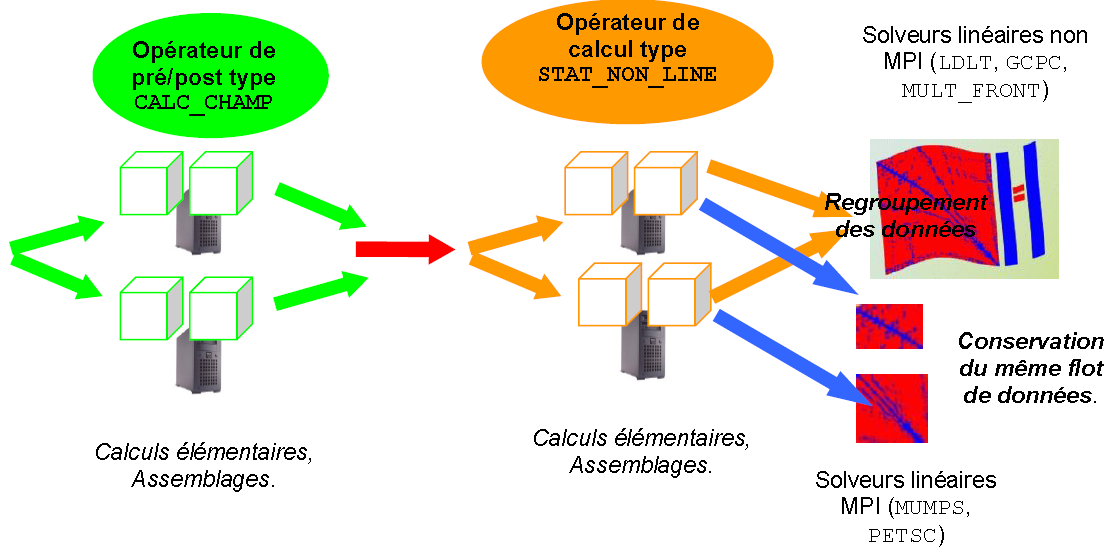
Figure 5.3.1._ Organisation du schéma parallèle MPI de construction et de résolution des systèmes linéaires.
Remarques:
Notons qu’à l’issue du cycle «construction de système linéaire – résolution de celui-ci», quelque soit le scénario mis en oeuvre (solveur linéaire séquentiel ou parallèle MPI), le vecteur solution est ensuite transmis, en entier, à tous les processus MPI. Le cycle peut ainsi continuer quelque soit la configuration suivante.
De plus, on peut superposer ou substituer à ce parallélisme MPI (qui fonctionne sur toutes les plate-formes), un autre niveau de parallélisme géré cette fois par le langage OpenMP . Celui-ci est cependant limité aux fractions de machine partageant physiquement la même mémoire (PC multi-coeurs ou nœuds de serveur de calcul).
Il ne permet pas de baisser les consommations mémoire mais par contre il accélère certains types de calcul et ce, avec une granularité plus faible que celle du MPI: il procure une meilleure accélération même si le flot de données/traitements n’est pas très important. C’est un schéma parallèle d’ordre «informatique» qui intervient principalement dans les opérations basiques d’algorithmes d’algèbre linéaire ( via par exemple la librairie BLAS et certaines étapes du solveur MUMPS).
Ce parallélisme peut être:
soit cumulé avec le parallélisme MPI de MUMPS en accélérant les calculs au sein de chaque processus MPI. On obtient alors un schéma parallèle hybride à 2 niveaux.
soit se substituer au parallélisme MPI en accélérant la résolution de système linéaire avec MULT_FRONT.
5.4. Distribution de calculs modaux#
Lorsque la simulation ne peut pas se décomposer en calculs Aster indépendants, mais qu’elle reste dominée néanmoins par des calculs modaux généralisés (opérateurs INFO_MODE et CALC_MODES), on peut organiser un schéma parallèle spécifique (cf. 5.4.1).
Fig
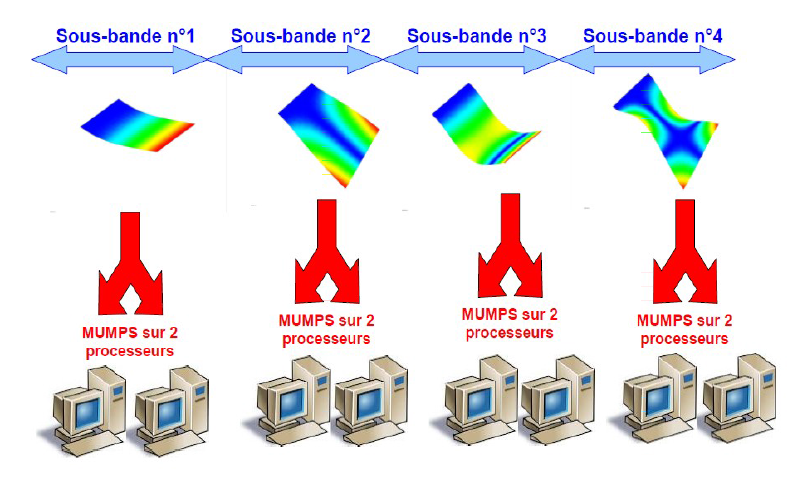
ure 5.4.1._ Organisation du schéma parallèle MPI de distribution des calculs modaux et de résolutions des systèmes linéaires associés.
Il est fondé sur la distribution de calculs modaux indépendants: chacun étant en charge d’une sous-bande fréquentielle.
Ce schéma parallèle d’ordre purement «informatique» ne procure que des gains en temps (sauf si on le cumul avec MUMPS). Il peut toutefois se mixer avec les schémas parallèles précédents:
chaînage entre différents opérateurs: parallélisme MPI de construction de matrices linéaires (dans par exemple CALC_MATR_ELEM) et résolution modale dans CALC_MODES.
cumul , au sein de CALC_MODES, en activant le parallélisme MPI (voire OpenMP) du solveur direct MUMPS. On obtient alors un schéma parallèle hybride à 2 ou 3 niveaux.