3. Commandes#
3.1. Le fichier de commandes#
Le fichier de commandes contient un ensemble de commandes, exprimées dans un langage spécifique à Code_Aster (qui doit respecter la syntaxe Python). Ces commandes sont analysées et exécutées par une couche logicielle de Code_Aster appelée «superviseur».
3.2. Le rôle du superviseur#
Le superviseur réalise différentes tâches, notamment :
une phase de vérification et d’interprétation du fichier de commandes,
une phase d’exécution des commandes interprétées.
Ces tâches sont détaillées dans le document [U1.03.01].
Le fichier de commandes est traité à partir de la ligne où se trouve le premier appel à la procédure DEBUT() ou à la procédure POURSUITE() , et jusqu’à la première occurrence de la commande FIN() . Les commandes situées avant DEBUT() ou POURSUITE() et après FIN() ne sont pas exécutées, mais doivent être syntaxiquement correctes).
Phase de vérification syntaxique:
lecture et vérification syntaxique de chaque commande ; toute erreur de syntaxe détectée fait l’objet d’un message, mais l’analyse se poursuit, |
vérification que tous les concepts utilisés comme arguments ont été déclarés dans une commande précédente comme concept produit d’un opérateur ; on vérifie aussi que le type de ce concept correspond au type demandé pour cet argument. |
Phase d’exécution:
le superviseur active successivement les différents opérateurs et procédures, qui réalisent les tâches prévues. |
3.3. Les principes et la syntaxe du langage de commande#
La conception modulaire de Code_Aster permet de présenter le code comme une suite de commandes indépendantes:
les procédures , qui ne produisent pas directement de résultats, mais assurent, entre autre, la gestion des échanges avec les fichiers externes, |
les opérateurs , qui réalisent une opération de gestion de données ou de calcul et produisent un concept résultat auquel l’utilisateur donne un nom. |
Ces concepts représentent des structures de données, que l’utilisateur peut manipuler. Ces concepts sont typés au moment de leur création et ne pourront être utilisés que comme argument d’entrée du type correspondant.
Les procédures et les opérateurs échangent donc les informations nécessaires et des valeurs par l’intermédiaire des concepts nommés.
La syntaxe complète des commandes et ses implications sur la rédaction du fichier de commandes sont détaillées dans le fascicule [U1.03.01]. On donne ici un exemple de quelques commandes (extraites de l’exemple commenté en [U1.05.00]):
mail = LIRE_MAILLAGE ( ) |
mod1 = AFFE_MODELE(MAILLAGE = mail, |
AFFE=_F(TOUT=”OUI”, |
PHENOMENE=”MECANIQUE”, |
MODELISATION=”AXIS”)) |
f_y = DEFI_FONCTION ( NOM_PARA = “Y” |
VALE =_F ( 0., 20000., |
4., 0. ) |
) |
charg = AFFE_CHAR_MECA_F ( MODELE = mod1 |
PRES_REP =_F ( GROUP_MA = (‘lfa’, ‘ldf’), |
PRES = f_y ) ) |
res1 = MECA_STATIQUE( MODELE=mod1, |
EXCIT=_F(CHARGE = charg), |
….) |
res1 = CALC_CHAMP ( reuse=res1, RESULTAT=res1, |
MODELE=mod1, |
CONTRAINTE=(“SIGM_ELNO”), |
DEFORMATION=(“EPSI_ELNO),); |
On notera quelques points généraux, que l’on peut observer sur l’exemple précédent:
toute commande commence en première colonne,
la liste des opérandes d’une commande est obligatoirement entre parenthèses, ainsi que les listes d’éléments,
un nom_de_concept ne peut apparaître qu” une seule fois dans le texte de commande comme concept produit, à gauche du signe \(=\) ,
la réutilisation d’un concept existantcomme concept produit , n’est possible que pour les opérateurs spécifiés à cet effet. Lorsque l’on utilise cette possibilité (concept réentrant), la commande utilise alors le mot-clé réservé «reuse».
une commande est composée d’un ou plusieurs mot_clé ou mot_clé_facteur, ces derniers étant eux-mêmes composés d’une liste de mot_clé entre parenthèses et précédée du préfixe _F. Dans l’exemple proposé, la commande AFFE_CHAR_MECA_F utilise le mot_clé MODELE et le mot_clé_facteur PRES_REP, qui est composé des deux mot_clé GROUP_MA et PRES.
Cette opération se fait :
soit avec écrasement des valeurs initiales. A titre d’exemple signalons la factorisation en place d’une matrice de rigidité :
matass = FACTORISER ( reuse=matass, MATR_ASSE= matass )
soit avec enrichissement du concept.
3.4. Règle de surcharge#
Une règle de surcharge utilisable, notamment pour toutes les opérations d’affectation, a été ajoutée aux règles d’utilisation d’un mot_clé_facteur avec plusieurs listes d’opérandes :
les affectations se font en superposant les effets des différents mot_clé,
en cas de conflit, le dernier mot_clé l’emporte sur les précédents.
Exemple : on souhaite affecter différents matériaux MAT1, MAT2 et MAT3 à certaines mailles:
mater = AFFE_MATERIAU ( MAILLAGE= mon_mail

AFFE = (_F( TOUT = ‘OUI’, MATER = MAT1 ),
_F( GROUP_MA = ‘mail2’, MATER = MAT2 ), _F( GROUP_MA = ‘mail1’, MATER = MAT3 ), _F( MAILLE = ( ‘m7’,’m8’ ), MATER = MAT3 ) ) )
On commence par affecter le matériau MAT1 à toutes les mailles.
On affecte ensuite le matériau MAT2 au groupe de mailles mail2 qui contient, les mailles m8, m9 et m10.
On affecte enfin le matériau MAT3 au groupe de mailles mail1(m5, m6 et m7) et aux mailles m7 et m8 , ce qui est source de conflit puisque la maille m7 fait déjà partie du groupe mail1. La règle de surcharge sera alors appliquée et on obtiendra finalement le champ de matériau suivant:
MAT1 : mailles m1 m2 m3 m4 MAT2 : mailles m9 m10 MAT3 : mailles m5 m6 m7 m8
L’effet progressif des différentes affectations de matériau est illustré dans le tableau ci-dessous.
Nom de la maille |
Champ de matériaux après la 1ère affectation |
Champ de matériaux après la 2ème affectation |
Champ de matériaux après la 3ème affectation |
champ de matériaux final |
m1 |
MAT1 |
MAT1 |
MAT1 |
MAT1 |
m2 |
MAT1 |
MAT1 |
MAT1 |
MAT1 |
m3 |
MAT1 |
MAT1 |
MAT1 |
MAT1 |
m4 |
MAT1 |
MAT1 |
MAT1 |
MAT1 |
m5 |
MAT1 |
MAT1 |
MAT3 |
MAT3 |
m6 |
MAT1 |
MAT1 |
MAT3 |
MAT3 |
m7 |
MAT1 |
MAT1 |
MAT3 |
MAT3 |
m8 |
MAT1 |
MAT2 |
MAT2 |
MAT3 |
m9 |
MAT1 |
MAT2 |
MAT2 |
MAT2 |
m10 |
MAT1 |
MAT2 |
MAT2 |
MAT2 |
3.5. Règle de rémanence#
La règle de surcharge précédente doit être complétée par une autre règle pour préciser ce qui se passe lorsqu’on peut affecter plusieurs quantités pour chaque occurrence d’un mot clé facteur.
Soit par exemple :
CHMEC1=AFFE_CHAR_MECA( MODELE=MO,
FORCE_INTERNE=(
_F( TOUT = “OUI”, FX = 1. ),
_F( GROUP_MA = “GM1”, FY = 2.),
))
La règle de surcharge nous dit que la deuxième occurrence de FORCE_INTERNE surcharge la première.
Mais que vaut FX sur une maille appartenant à GM1 ? a-t-il été effacé par la deuxième occurrence ?
Si la seule règle de surcharge est appliquée, FX n’est pas défini sur GM1.
La règle de rémanence permet de conserver la valeur de FX.
Si la règle de rémanence est appliquée, FX conserve la valeur affectée au préalable. Tous les éléments du modèle ont une valeur pour FX et les éléments de GM1 pour une valeur pour FX et FY.
3.6. Bases mémoire associées à une étude#
Code_Aster s’appuie, pour la gestion de toutes les structures de données associées aux différents concepts manipulés, sur la bibliothèque JEVEUX. Celle-ci prend en charge la gestion de l’ espace mémoire demandé par l’utilisateur lors de la demande d’exécution (paramètre Mémoire exprimé en Mégaoctets). Cet espace est fréquemment insuffisant pour conserver en mémoire centrale toutes les structures de données. La bibliothèque prend alors en charge, la gestion des échanges entre la mémoire centrale et des mémoires auxiliaires sur fichiers.
Chaque entité est affectée, lors de sa création par le code, à un fichier d’accès direct . Celui-ci peut être considéré comme une base de données , puisqu’il contient, en fin d’exécution le répertoire (noms et attributs) qui permet d’exploiter tous les segments de valeurs qu’il contient.
Code_Aster utilise plusieurs bases de données :
la base de données GLOBALE, qui contient tous les concepts produits par les opérateurs, ainsi que le contenu de certains catalogues sur lesquels s’appuient les concepts ; le fichier associé à cette base permet la poursuite ultérieure d’une étude. Elle doit donc être gérée par l’utilisateur.
les autres bases de données, utilisées uniquement par le Superviseur et les opérateurs, au cours d’une exécution, ne nécessitent pas d’intervention particulière de l’utilisateur.
Réaliser une étude, c’est demander l’enchaînement de plusieurs commandes :
des procédures pour échanger des fichiers avec le monde extérieur,
des opérateurs pour créer des concepts produits au fur et à mesure du déroulement des opérations de modélisation et de calcul.
Les commandes qui correspondent à cet enchaînement d’opérations peuvent être réalisées de différentes façons, à partir du module exécutable unique de Code_Aster :
en une seule exécution séquentielle, sans intervention de l’utilisateur,
en fractionnant l’étude en plusieurs exécutions successives, avec réutilisation des résultats antérieurs; à partir de la seconde exécution, l’accès à la base de données se fait en poursuite ; à l’occasion d’une poursuite, on peut redemander la dernière commande, si elle s’est interrompue prématurément (manque de temps, données incomplètes ou incorrectes détectées en phase d’exécution, …).
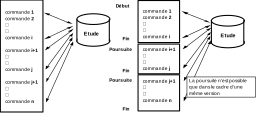
Pour gérer ces possibilités, on notera que trois commandes jouent un rôle primordial. Ce sont celles qui correspondent aux procédures qui activent le superviseur :
|
obligatoire pour la première exécution d’une étude, |
|
obligatoire à partir de la deuxième exécution d’une étude, |
|
obligatoire pour toutes les exécutions. |
Pour une étude donnée, on peut soumettre des fichiers de commandes ayant la structure suivante:
Remarques :
La commande INCLUDEpermet d’inclure dans un flot de commandes le contenu d’un autre fichier de commandes. Ceci permet notamment de conserver un fichier des commandes principales lisible et de placer dans des fichiers annexés des données numériques volumineuses (ex: définition de fonctions).
Les fichiers de commandes peuvent être découpés en plusieurs fichiers qui seront exécutés l’un après l’autre, avec sauvegarde intermédiaire de la base de données. Pour cela, il faut définir les fichiers de commandes successifs, dont le suffixe sera: .com1, .com2, …, .com9. Les exécutions de ces fichiers sont enchaînées. La base de données de la dernière exécution qui s’est bien terminée est conservée.
3.7. Aide à la définition des valeurs#
3.7.1. Substitution de valeurs#
Il est possible de paramétrer un fichier de commandes.
Par exemple:
Eptub = 26.187E-3
Rmoy = 203.2E-3
Rext = Rmoy+(EPtub/2)
cara = AFFE_CARA_ELEM ( MODELE = modele
POUTRE =_F ( GROUP_MA = tout , SECTION : “CERCLE”,
CARA = ( “R”,”EP” ) , VALE = ( Rext , EPtub)))
3.7.2. Fonctions de un ou plusieurs paramètres#
Il est également souvent nécessaire d’utiliser des grandeurs fonctions d’autres paramètres.
Celles-ci peuvent être :
soit définies sur un fichier externe lu par la commande LIRE_FONCTION.
soit définies dans le fichier de commandes par:
DEFI_CONSTANTE qui produit un concept fonction avec une seule valeur constante,
DEFI_FONCTION qui produit un concept fonction pour une grandeur fonction d’un paramètre réel,
DEFI_NAPPE qui produit un concept fonction pour une liste de fonctions d’une même grandeur, chaque élément de la liste correspondant à une valeur d’un autre paramètre réel.
Le concept produit par ces opérateurs est de type fonction et ne peut être utilisé que comme argument d’opérandes qui acceptent ce type. Les opérateurs qui acceptent un argument de type fonction ont pour suffixe F (ex: AFFE_CHAR_MECA_F). Les fonctions sont dans ce cas définies point par point, avec un interpolation linéaire par défaut, donc affines par morceaux.
Les fonctions créées sont des tables discrètes des grandeurs spécifiées à la création. Lors d’une recherche de valeur, on procède suivant les caractéristiques spécifiées, par recherche directe ou par interpolation dans la table (linéaire ou logarithme). On peut spécifier, lors de la création de la fonction, le prolongement hors du domaine de définition de la table, avec différentes règles, ou l’interdire.
soit définies à l’aide de leur expression analytique par l’opérateur FORMULE. Par exemple:
omega = 3.566 ;
linst = ( 0., 0.01, 0.02, 0.03, 0.04, 0.05, 0.06, 0.07, 0.08, 0.09, 0.10, 0.20, 0.40 )
F = FORMULE(VALE = “””COS(OMEGA*INST)”””)
F1=CALC_FONC_INTERP( FONCTION=F, VALE_PARA= linst,
NOM_RESU=”ACCE”,)
La fonction analytique \(F(t)=\cos(\Omega t)\) est ensuite calculée par CALC_FONC_INTERP pour les instants de la liste linst liste d’instants t.
3.8. Comment rédiger son fichier de commandes avec AsterStudy ?#
Pour rédiger un fichier de commandes de Code_Aster , le plus immédiat consiste à partir d’un exemple déjà rédigé par d’autres. En particulier, l’ensemble des tests de Code_Aster constitue souvent une bonne base de départ pour une nouvelle modélisation. Ils sont documentés en tant que documentation de validation.
Mais il y a mieux: l’outil AsterStudy permet de rédiger de façon interactive et conviviale son fichier de commandes, en proposant d’accéder aux tests de Code_Aster disponibles, et pour chaque commande la liste des mots clés possibles en vérifiant automatiquement la syntaxe, les concepts disponibles, en permettant de visualiser sur le maillage les entités utilisées, et en donnant accès à la documentation du Manuel d’utilisation (fascicules [U4] et [U7]).