5. Consommation mémoire RAM#
A chaque instant, l a mémoire RAM utilisée par Code_Aster peut être le cumul de trois composantes.
La mémoire allouée directement par les sources du code. Il s’agit principalement de celle allouée par le progiciel JEVEUX [D6.02.01] pour gérer toutes les structures de données F77 du code. Ce progiciel permet aussi de décharger sur disque ces objets (fonctionnalité Out-Of-Core). Suivant la taille du problème, celle de la RAM et les préconisations du programmeur, JEVEUX effectue des échanges de données plus ou moins prononcés entre le disque et la RAM.
La mémoire utilisée par un logiciel externe sollicité par le calcul Aster (MUMPS/PETSc, METIS/SCOTCH, HOMARD, MISS3D…). La plupart des logiciels externes fonctionnent en In-Core. C’est-à-dire qu’ils ne gèrent pas directement les éventuels débordements mémoire et qu’ils sous-traitent cette tâche au système d’exploitation. D’autres, comme le solveur linéaire MUMPS, sont potentiellement OOC et ils gèrent eux-même explicitement le déchargement sur disque de certains gros objets (cf. mot-clé SOLVEUR/GESTION_MEMOIRE[U4.50.01]).
La mémoire requise par le système (chargement d’une partie de l’exécutable, couche réseau en parallèle…) et par le superviseur et les librairies Python.
Lorsqu’on utilise un opérateur Code_Aster requérant la construction et la résolution de systèmes linéaires (par ex. STAT_NON_LINE ou CALC_MODES), les limitations mémoires sont souvent imposées par le solveur linéaire (cf. [U4.50.01][U2.08.03]). Lorsqu’il s’agit de solveurs internes (LDLT, MULT_FRONT, GCPC), leurs consommations RAM se retrouvent dans les affichages JEVEUX. Par contre, lorsqu’on utilise un produit externe (MUMPS ou PETSC), il faut alors tenir compte de sa consommation propre (qui se substituent en grande partie à celle de JEVEUX).
Résolution via MUMPS
**usol*
Déroulement du calcul
Construction système linéaire
Ku=F
Consommation RAM
Mémoire MUMPS
MémoireJEVEUX
Figure 5-a: Schéma d’évolution de la consommation RAM au cours
d’un calcul standard en mécanique linéaire.
5.1. Calibration mémoire d’un calcul#
Il est souvent intéressant de calibrer au niveau mémoire RAM un calcul Aster. Cela peut, par exemple, permettre d’optimiser son placement dans une classe batch (séquentielle ou parallèle) ou tout simplement éviter son arrêt brutal du fait d’un défaut de mémoire. Pour ce faire, on peut procéder comme suit:
Etape n°1 : repérer dans le déroulement du calcul l’opérateur qui semble le plus dimensionnant en taille de problème (c’est souvent le STAT/DYNA_NON_LINEou le CALC_MODES… traitant le plus gros modèle).
Etape n°2: si ce n’est pas le cas, paramétrer le bloc SOLVEURde cet opérateur avec METHODE=”MUMPS’et GESTION_MEMOIRE=”EVAL”. A l’issue de la calibration, éventuellement penser à remettre l’ancien paramétrage.
Etape n°3: lancer le calcul tel quel avec des paramètres mémoire et temps modestes par rapport aux consommations usuelles de ce type de calcul. En effet, avec cette option, Code_Aster va juste construire le premier système linéaire de l’opérateur et le transmettre à MUMPS pour analyse. Ce dernier ne va pas effectuer son étape la coûteuse (en temps et surtout en mémoire) de factorisation numérique. Une fois cette analyse achevée, les estimés mémoire de MUMPS (\({\mathit{MUE}}_{\mathit{IC}}\) et \({\mathit{MUE}}_{\mathit{OOC}}\) ), jointes à celle de JEVEUX(\({\mathit{JE}}_{\mathit{OOC}}\) ), sont tracées dans le fichier message (cf. figure 5.1-a). Puis le calcul s’arrête en ERREUR FATALEafin de permettre de passer le plus rapidement possible à l’étape suivante.


===> Pour ce calcul, il faut donc une quantité de mémoire RAM au minimum de - 3500 Mo si GESTION_MEMOIRE=”IN_CORE”, - 500 Mo si GESTION_MEMOIRE=”OUT_OF_CORE”. En cas de doute, utilisez GESTION_MEMOIRE=”AUTO”. ************************************************************************** |
===> Pour ce calcul, il faut donc une quantité de mémoire RAM au minimum de - 3500 Mo si GESTION_MEMOIRE=”IN_CORE”, - 500 Mo si GESTION_MEMOIRE=”OUT_OF_CORE”. En cas de doute, utilisez GESTION_MEMOIRE=”AUTO”. ************************************************************************** |
Figure 5.1-a : Affichage dans le fichier message en mode “ EVAL.
Etape n°4 : exploitation des estimés mémoires proprement dites.
Pour relancer le calcul avec le solveur linéaire MUMPS, on a directement accès aux valeurs «plancher» de la mémoire RAM indispensables au calcul. On distingue deux cas de figure suivant le mode de gestion mémoire de MUMPS choisit: In-Core (valeur \(max({\mathit{JE}}_{\mathit{OOC}},{\mathit{MUE}}_{\mathit{IC}})\) si GESTION_MEMOIRE=”IN_CORE”) ou Out-Of-Core (valeur \(max({\mathit{JE}}_{\mathit{OOC}},{\mathit{MUE}}_{\mathit{OOC}})\) si GESTION_MEMOIRE=”OUT_OF_CORE”). Suivant la machine/les classes batch dont on dispose, il faut donc relancer le calcul complet en modifiant aussi éventuellement ce paramètre du bloc SOLVEUR.
Ces estimées sont établies pour une configuration informatique et numérique donnée : plate-forme matérielle, librairies, nombre de processus MPI, renuméroteur, pré-traitements…
Etape n°4bis : par contre, si on souhaite relancer le calcul en changeant de solveur linéaire ou un des paramètres numériques, il est plus difficile d’en déduire l’estimée mémoire adaptée. La combinatoire et la variabilité des possibilités sont trop importantes. On peut toutefois proposer quelques règles empiriques (en mode séquentiel). Grossièrement, si au lieu de METHODE=”MUMPS” on choisit “MULT_FRONT” l’estimée mémoire devrait rester licite (avec RENUM=”METIS” valeur par défaut). Avec “LDLT”, ce chiffre doit être significativement revu à la hausse. Avec “PETSC”/”GCPC”+”LDLT_SP”, il peut être sans doute réduit à \(max({\mathit{JE}}_{\mathit{OOC}},{\mathit{MUE}}_{\text{IC/OOC}}/2)\) . Avec “PETSC”/”GCPC”+”LDLT_INC” il peut être sans doute réduit à un facteur fois \({\mathit{JE}}_{\mathit{OOC}}\) suivant le niveau de remplissage du préconditionneur (mot-clé NIVE_REMPLISAGE cf.[R6.01.02]).
Etape n°5: relancer le calcul complet en modifiant éventuellement le paramétrage du bloc SOLVEUR et en paramétrant Astk avec la valeur déduite à l’étape n°4 (menu «Mémoire totale(Mo)» de la figure 5.2-b).
Remarque:
Cette procédure de calibration mémoire d’une étude n’est disponible que depuis la restitution du mot-clé SOLVEUR/GESTION_MEMOIRE (à partir de la version v11.2 de Code_Aster). Pour des versions plus anciennes, si le calcul a déjà été lancé (et si on dispose d’un fichier de message exploitable), on peut, a minima, reprendre prudemment comme estimation optimale de la mémoire requise, la plus grande valeur sur tous les processeurs du Vmpeak du dernier opérateur. Sinon, il faut procéder comme mentionné dans les versions antérieures de ce document:
**Etape n°1:comme ci-dessus.*
**Etape n°2:paramétrer le bloc* SOLVEURavec METHODE=”MUMPS”,”OUT_OF_CORE”=”OUI” et INFO=2.
**Etape n°3:lancer le calcul en limitant la consommation en temps (par exemple, avec peu de pas de temps ou peu de recherche de modes propres).*
**Etape n°4:suivant le mode de gestion mémoire de MUMPS requis (IC ou OOC), prendre le maximum de l’estimation MUMPS et de la consommation* JEVEUX.
5.2. Consommations mémoire JEVEUX#
Des éléments pour chiffrer les consommations mémoire de JEVEUX sont tracés en fin de chaque opérateur Aster (cf. figure 5.2-a). A grands traits, on peut les expliciter de la façon suivante:
\({\mathit{JE}}_{\mathit{OOC}}\) fournit la taille minimale (“Minimum”) dont à besoin JEVEUXpour fonctionnerjusqu’à cet opérateur . Il sera alors complètement Out-Of-Core (OOC). En deçà de cette valeur, le calcul n’est pas possible (dans la configuration retenue).
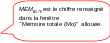
\({\mathit{JE}}_{\mathit{IC}}\) fournit une borne inférieure (“Optimum”), jusqu’à cet opérateur, de la mémoire JEVEUX nécessaire pour fonctionner complètement en In-Core (IC): \({\mathit{JE}}_{\mathit{IC}}^{'}\) . Avec au moins cette valeur de mémoire RAM paramétrée dans Astk (cf. \({\mathit{MEM}}_{\mathit{ASTK}}\) ), le calcul se déroulera de manière optimale: il n’y a pas de risque de planton dû à un manque de mémoire et les accès aux structures de données purement Aster sont peu ralentis par les déchargements sur disque.
Ces deux chiffres sont forcément inférieurs à la valeur totale de mémoire RAM consacrée au calcul(paramétrée dans Astk ), notée \({\mathit{MEM}}_{\mathit{ASTK}}\) .
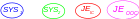
# Statistiques mémoire(Mo) : 15521.78/ 8920.14/ 1603.77/ 248.27(VmPeak/VmSize/Optimum/Minimum)
Figure 5.2-a: Statistiques globales à l’issue de chaque commande
(extrait d’un .mess ).
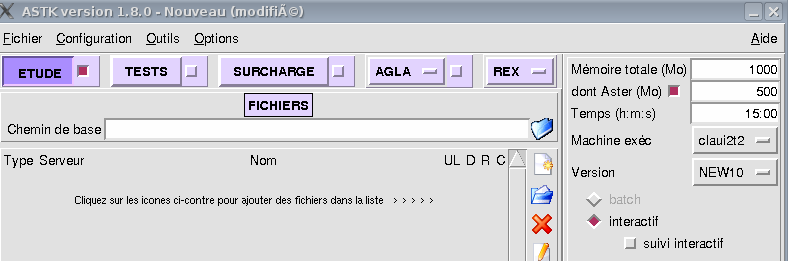
Figure 5.2-b: Paramétrage dans Astk de la mémoire RAM.
Remarque:
Si il n’y a eu aucun mécanisme global de libération (cf. paragraphe ci-dessous), \({\mathit{JE}}_{\mathit{IC}}\) représente véritablement la mémoire JEVEUX requise pour fonctionner en IC. Sinon, cette dernière estimation doit être proche de la somme [11]_ \({\mathit{JE}}_{\mathit{IC}}^{'}={\mathit{JE}}_{\mathit{IC}}+.\) «le gain moyen procuré par chaque libération». Il ne sert donc à rien (si on n’utilise pas de produit externe) de paramétrer le calcul avec une valeur très supérieure à \({\mathit{JE}}_{\mathit{IC}}^{'}\) *.*
Lors du paramétrage du calcul, il faut donc établir un compromis entre sa rapidité et ses consommations mémoire . En hiérarchisant les consommations mémoires de toutes les commandes, on peut repérer celle qui dimensionne le calcul. A configuration de calcul fixée (nombre de processeurs), plus l’espace mémoire réservé à JEVEUX sera grand, plus le calcul sera In-Core (IC) et donc plus il sera rapide. On peut aussi, suivant les contingences des files d’attente batch, découper son calcul en différentes POURSUITE de manière à panacher et ainsi optimiser les paramétrages «temps calcul/mémoire».
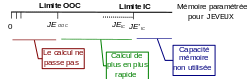
Figure 5.2-c :Signification des affichages liés à JEVEUX dans le fichier message.
En cours de calcul, JEVEUXpeut décharger une grande partie des objets de la RAM sur le disque . Ce mécanisme est soit:
Automatique (il n’y a plus assez d’espace RAM pour créer un objet ou le rapatrier),
Géré par le programmeur (par ex. appel à ce mécanisme de libération juste avant de céder la main à MUMPS).
Les statistiques concernant ce mécanisme sont récapitulées en fin de fichier message (cf. §5.2-d) pour l’ensemble des commandes. Évidemment, plus ce mécanisme intervient (et sur de gros volumes de mémoire libérés), plus le calcul s’en trouve ralenti (temps système et elapsed qui grandissent et temps CPU stable). Ce phénomène peut se trouver accentué en mode parallèle (contentions mémoires simultanées) suivant la répartition des processeurs sur les nœuds de calcul et suivant les caractéristiques de la machine.
STATISTIQUES CONCERNANT L’ALLOCATION DYNAMIQUE :
TAILLE CUMULEE MAXIMUM : 1604 Mo.
TAILLE CUMULEE LIBEREE : 52117 Mo.
NOMBRE TOTAL D’ALLOCATIONS : 1088126

NOMBRE TOTAL DE LIBERATIONS : 1088126
APPELS AU MECANISME DE LIBERATION : 1
TAILLE MEMOIRE CUMULEE RECUPEREE : 1226 Mo.
VOLUME DES LECTURES : 0 Mo.
VOLUME DES ECRITURES : 1352 Mo.
MEMOIRE JEVEUX MINIMALE REQUISE POUR L’EXECUTION : 248.27 Mo
IMPOSE DE NOMBREUX ACCES DISQUE
RALENTIT LA VITESSE D’EXECUTION
MEMOIRE JEVEUX OPTIMALE REQUISE POUR L’EXECUTION : 1603.77 Mo
LIMITE LES ACCES DISQUE
AMELIORE LA VITESSE D’EXECUTION
Figure 5.2-d:Statistiques du mécanisme JEVEUX de libération (.mess).
Ces statistiques récapitulent aussi les estimées \({\mathit{JE}}_{\mathit{IC}}\) et \({\mathit{JE}}_{\mathit{OOC}}\) détaillées précédemment.
Remarque:
On trace les éventuels surcoûts en temps de ces déchargements à la fin des opérateurs concernés (cf. §4.1.1). Dans le cas d’un manque de RAM, on peut diagnostiquer celui-ci via le paramètre “VmPeak” (cf. §5.4).
5.3. Consommations mémoire de produits externes (MUMPS)#
Pour l’instant, le seul produit externe dont la consommation mémoire RAM soit vraiment dimensionnante, est le produit MUMPS . On peut tracer ses consommations (In-Core et Out-Of-Core) de deux manières:
Par un pré-calcul très rapide et peu coûteux en mémoire via le mode GESTION_MEMOIRE=”EVAL”(cf. §5.1). Mais il ne s’agit que d’estimations (valeurs \({\mathit{ME}}_{\mathit{IC}}\) et \({\mathit{ME}}_{\mathit{OOC}}\) de figure 5.1-a). Elles peuvent donc être un peu pessimistes (surtout en Out-Of-Core et/ou en parallèle). En mode parallèle, on ne trace que les estimées du processus MPI le plus gourmand.
Par le calcul standard (limité si possible à quelques pas de temps ou à quelques modes propres) en rajoutant le mot-clé INFO=2 dans la commande supposée la plus coûteuse. On récapitule alors dans le fichier message (cf. 5.3-a), non seulement les estimées mémoire \({\mathit{ME}}_{\mathit{IC}}\) et \({\mathit{ME}}_{\mathit{OOC}}\) précédentes (colonnes “ESTIM IN-CORE” et “ESTIM OUT-OF-CORE”), mais aussi la consommation réelle du mode choisi \({\mathit{MR}}_{\text{IC/OOC}}\) (ici en mode OOC car affichage “RESOL OUT-OF-CORE”). Par exemple, dans la figure 5.3-a, il faut lire: «MUMPS estime avoir besoin d’au moins \({\mathit{ME}}_{\mathit{OOC}}=\mathrm{478Mo}\) par processeur pour fonctionner en OOC. Pour passer en IC (calcul plus rapide), il estime avoir besoin d’au moins \({\mathit{ME}}_{\mathit{IC}}=\mathrm{964Mo}\) ; En pratique, il a consommé exactement \({\mathit{MR}}_{\mathit{OOC}}=\mathrm{478Mo}\) en OOC (l’estimé est donc parfaite: \({\mathit{ME}}_{\mathit{OOC}}={\mathit{MR}}_{\mathit{OOC}}\) !).
En mode parallèle, on récapitule les chiffres par processus MPI, ainsi que leurs minima, maxima et moyennes. C’est un affichage à vocation d’expertise qui est plus détaillé que l’affichage du mode GESTION_MEMOIRE=”EVAL”. Outre ces informations de consommation RAM, il récapitule aussi des éléments liés au type de problème, à sa difficulté numérique (erreurs) et à sa distribution parallèle (équilibre de charge).
******************************************************************************

< **MONITORING DMUMPS 4.8.4**  >

TAILLE DU SYSTEME 210131

**RANG** **NBRE MAILLES** **NBRE TERMES K** **LU FACTEURS**

N 0 : 5575 685783 45091154

N 1 : 8310 1067329 51704129

N 2 : 11207 1383976 53788943

...

N 7 : 8273 1039085 4560659

-----------------------------------------------------------

TOTAL: 67200 8377971 256459966

**MEMOIRE RAM ESTIMEE ET REQUISEPAR MUMPS EN MO** (FAC_NUM + RESOL)

*MROOC*
**RANG ASTER : ESTIM IN-CORE | ESTIM OUT-OF-CORE | RESOL. OUT-OF-CORE**

*MEIC*

*MEOOC*
N 0 : 869 478 478

N 1 : 816 439 439

N 2 : 866 437 437

...

N 7 : 754 339 339

-----------------------------------------------------------------------------

**MOYENNE**  : 5.92D+02 3.50D+02 3.50D+02

-----------------------------------------------------------------------------

**MINIMUM**  : 7.54D+02 3.39D+02 3.39D+02

-----------------------------------------------------------------------------

**MAXIMUM**  : 9.64D+02 4.78D+02 **4.78D+02**

-----------------------------------------------------------------------------

*****************************************************************************
Figure 5.3-a:Consommations mémoires par processeur (estimations et réalisés) du produit externe MUMPS (affichage dans le .mess si INFO=2).
Remarques :
Suivant le type de calcul (séquentiel, parallèle centralisé ou distribué), le nombre de processeurs, le mode d’utilisation de JEVEUX(mot-clé SOLVEUR/MATR_DISTRIBUEE) et du gestionnaire mémoire MUMPS(mot-clé SOLVEUR/GESTION_MEMOIRE), la hiérarchie mémoire peut cependant être bousculée *. En mode parallèle distribué, le pic mémoire* JEVEUX va baisser avec le nombre de processeurs dès que MATR_DISTRIBUE va être activé. Cela va aussi être le cas pour MUMPS , quelque soit le mode de parallélisme (surtout en IC). D’ailleurs, le passage de MUMPS du mode IC au mode OOC va aussi drastiquement faire chuter son pic mémoire.
L’affichage en INFO=2 des consommations RAM de MUMPS par processeur renseigne quant à d’éventuels déséquilibrages de charge mémoire. On peut essayer de les limiter en modifiant l’heuristique d’ordonnancement du produit: paramètres SOLVEUR/PRETRAITEMENTS et RENUM ou le nombre de processeurs.
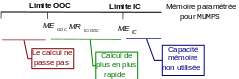
Figure 5.3-b:Signification des affichages liés à MUMPS dans le fichier message.
5.4. Consommations système#
Les seules consommations systèmes mentionnées dans le fichier message concernent la mémoire globale du job à cet instant du calcul (VmSize) et son pic depuis le début (VmPeak). Elle est tracée à l’issue de chaque commande (cf. chiffres \({\mathit{SYS}}_{1}/{\mathit{SYS}}_{2}\) figure 5.2a). Le VmPeak est récapitulée en fin de fichier message (cf. figure 5.4a).

MAXIMUM de MEMOIRE UTILISEE PAR LE PROCESSUS : 15107.89 Mo
COMPREND LA MEMOIRE CONSOMMEE PAR JEVEUX,
LE SUPERVISEUR PYTHON, LES LIBRAIRIES EXTERNES
Figure 5.4-a: Vmpeak final du processus Unix.
A grands traits VmPeak renseigne quant au pic en taille mémoire causé par tous les exécutables actifs du job Aster . Il faut veiller à ce que ce chiffre reste inférieur à la mémoire physique dont dispose le job. Sinon, le système va, jusqu’à un certain point, «swapper» et cela va ralentir le calcul. Au niveau du progiciel JEVEUX cela se traduira par plus de déchargements (cf. §4.1.2 et §5.2) et, au niveau des produits externes, par un écart ELAPS/USER grandissant (tracé en fin de commande cf. §4.1.1).
Remarques si SOLVEUR=”MUMPS” :
Depuis la restitution du mot-clé SOLVEUR/GESTION_MEMOIRE(à partir de la version v11.2 de Code_Aster), on permet au solveur de «s’étaler» en mémoire, en complément des allocations JEVEUX/Python/librairies, jusqu’à occuper la taille maximale allouée. Cela permet au produit d’être plus rapide et moins sourcilleux sur ses besoins mémoire en terme de pivotage. Par contre, corolaire de cette stratégie d’occupation optimum des ressources mémoire, le VmPeakaffiché dans le fichier message devient dépendant de la mémoire allouée au calcul (MEMASTKou borne de la classe batch). Il ne peut donc pas servir, comme auparavant, à calibrer les consommations mémoires minimales de l’étude. Pour ce faire, il faut plutôt appliquer la stratégie détaillée au §5.1